

پژوهش بیش از ۸ میلیون پیام نشان میدهد توهین به چتباتهای هوش مصنوعی شانس اصلاح پاسخ را کاهش میدهد و بازخورد مستقیم مؤثرتر است.
فهرست مطالب
بررسی بیش از ۸ میلیون پیام در چتباتهای هوش مصنوعی نشان میدهد که اصلاح مستقیم و محترمانه پاسخها، احتمال رفع اشتباه چتباتها را افزایش میدهد.
به گزارش سرویس هوش مصنوعی تکناک، فحش دادن به چتباتهای هوش مصنوعی نهتنها کمکی به بهبود پاسخهای آنها نمیکند، بلکه احتمال اصلاح اشتباهات را نیز کاهش میدهد. پژوهش جدید پلتفرم Searchable نشان میدهد که کاربران با گوشزد کردن مستقیم خطاها، نتیجه بهتری میگیرند. در مقابل، استفاده از کلمات توهینآمیز باعث میشود مدل اطلاعات مفید کمتری برای اصلاح پاسخ در اختیار داشته باشد.
براساس این بررسی، ۳۳ درصد از کاربران آمریکایی چتباتها در یک سال گذشته به ChatGPT، جمینای یا کلاد ناسزا گفتهاند یا به آنها توهین کردهاند. بااینحال، واکنش مستقیم و بدون توهین تأثیر بیشتری بر اصلاح پاسخها داشته است.
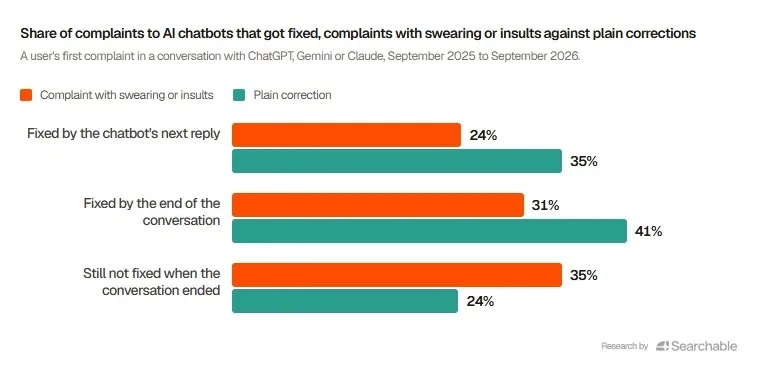
وقتی کاربران اشتباه چتبات را بدون استفاده از الفاظ نامناسب توضیح دادند، این ابزار در ۳۵ درصد موارد در پاسخ بعدی خود مشکل را برطرف کرد. اما زمانی که کاربران از ناسزا یا توهین استفاده کردند، میزان موفقیت به ۲۴ درصد کاهش یافت. این تفاوت نشان میدهد که ارائه اطلاعات مشخص درباره خطا، برای اصلاح پاسخ مفیدتر از ابراز خشم است.
چه عواملی کاربران را به توهین وادار میکنند؟
پلتفرم Searchable بیشاز ۸ میلیون پیام ناشناس را که بین سپتامبر ۲۰۲۵ تا سپتامبر ۲۰۲۶ ارسال شده بودند، بررسی کرد تا دلایل اصلی نارضایتی کاربران از چتباتها را شناسایی کند.
نادیده گرفتن دستورالعملهای کاربران با سهم ۱۹ درصدی، مهمترین عامل ارسال پیامهای توهینآمیز بود. پاسخهای اشتباه با ۱۸ درصد در جایگاه دوم قرار گرفتند و برداشت نادرست از درخواست کاربران نیز ۱۵ درصد از سهم پاسخهای اشتباه را به خود اختصاص داد.
نتایج بررسی همچنین تفاوتهایی میان گروههای مختلف کاربران نشان داد. مردان یکسوم بیشتر از زنان از واژههای توهینآمیز استفاده کردند. کاربران ۳۵ تا ۴۴ ساله نیز در مقایسه با سایر گروههای سنی، بیشترین میزان ناسزاگویی به چتباتها را داشتند. در رتبهبندی مناطق جغرافیایی هم ایالت نوادا و شهر لاسوگاس در صدر قرار گرفتند.
آزمایشهای دانشگاهی نیز برتری دستورهای ساده و مستقیم را تأیید میکنند. در آزمایشی که دانشگاه پنسیلوانیا در سال ۲۰۲۶ انجام داد، دستورهای بدون مقدمههای توهینآمیز یا بیش از حد مؤدبانه در مدل GPT-5-nano به امتیاز ۸۲ درصد رسیدند. در مقابل، دستورهای تهدیدآمیز فقط ۷۱ درصد امتیاز کسب کردند.
آزمایشهای پیشین آزمایشگاههای هوش مصنوعی مولد دانشگاه وارتون نیز نشان دادند که تهدید کردن یا پیشنهاد رشوه به مدلهایی مانند GPT-4o، دقت آنها را در پاسخگویی به پرسشهای پیچیده علمی افزایش نمیدهد.
محدودیتهای جدید آنتروپیک برای رفتار با کلود
همزمان با انتشار این یافتهها، شرکت آنتروپیک در ۱۲ نوامبر ۲۰۲۶ سیاست استفاده از محصولات خود را تغییر داد. طبق قوانین جدید، رفتارهای توهینآمیز، بیرحمانه و مداوم و بدون دلیل موجه علیه مدلهای این شرکت ممنوع است.
طبق گزارش اندروید هدلاینز، آنتروپیک تأکید کرده است که ابراز نارضایتی معمولی یا اشاره به اشتباهات کلود همچنان مجاز خواهد بود. بااینحال، رفتارهای توهینآمیز و مکرر ممکن است باعث شوند این چتبات به مکالمه پایان دهد.
مدیران این شرکت میگویند محدودیت جدید اقدامی پیشگیرانه برای مواجهه با احتمال مطرح شدن موضوع رفاه هوش مصنوعی در آینده است. آنها تأکید میکنند که این تصمیم به معنای برخورداری چتباتهای امروزی از احساسات نیست.
در مجموع، نتایج این بررسی نشان میدهند که کاربران برای دریافت پاسخ بهتر، باید بهجای توهین، بخش اشتباه پاسخ را مشخص کنند و توضیح دهند چه چیزی نیاز به اصلاح دارد. چنین بازخوردی اطلاعات دقیقتری در اختیار مدل قرار میدهد و احتمال اصلاح پاسخ در تلاش بعدی را افزایش میدهد.