

گزارش وارتون نشان میدهد شرکتها درباره مسئولیت خطاهای عاملهای هوش مصنوعی سردرگماند؛ از خطاهای قیمتگذاری تا ارسال پیامهای اشتباه به مشتریان.
گزارش جدید مدرسه وارتون نشان میدهد شرکتها هنوز درباره مسئولیت خطاهای پرهزینه عاملهای هوش مصنوعی به توافق نرسیدهاند؛ مشکلی که با افزایش استقلال این ابزارها در محیط کار جدیتر میشود.
گسترش استفاده از عاملهای هوش مصنوعی در سازمانها، در کنار افزایش بهرهوری، پرسش مهمی را درباره مسئولیتپذیری مطرح کرده است: اگر یک سامانه هوشمند مرتکب اشتباهی پرهزینه شود، چه کسی باید پاسخگو باشد؟ مدیر، کارمند استفادهکننده، تیم مدیریت ریسک یا شرکت توسعهدهنده فناوری؟
بر اساس گزارش مدرسه وارتون دانشگاه پنسیلوانیا، مدیران و شرکتها هنوز رویکرد مشخص و یکسانی برای تعیین مسئولیت خطاهای عاملهای هوش مصنوعی ندارند. این ابهام در شرایطی اهمیت بیشتری پیدا میکند که سازمانها وظایف حساستری را به سامانههایی میسپارند که میتوانند با نظارت محدود، برای مدت طولانی فعالیت کنند.
مسئولیت خطای هوش مصنوعی بر عهده چه کسی است؟
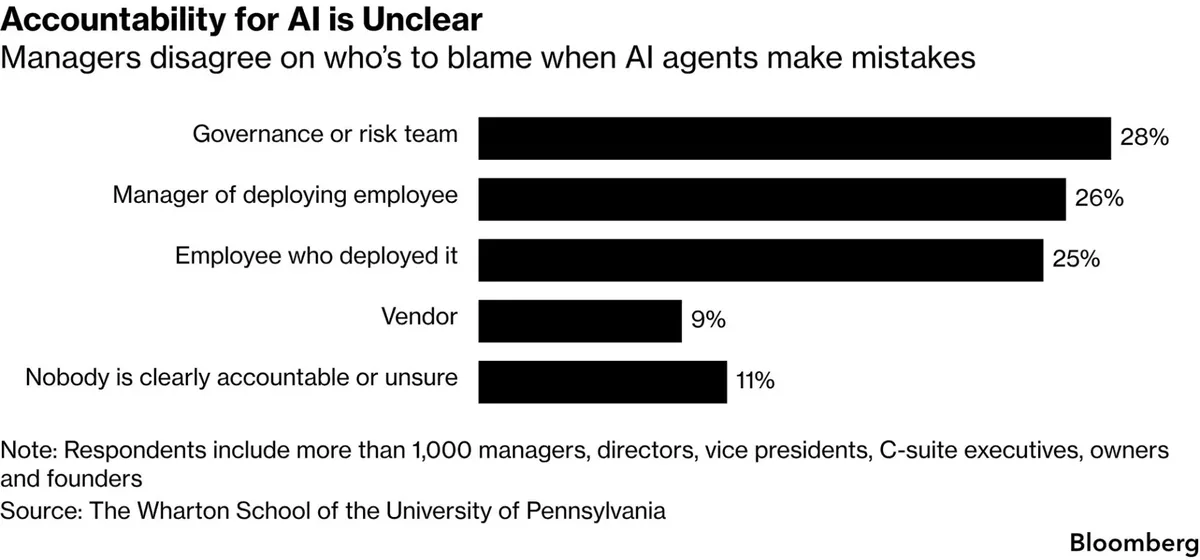
نتایج نظرسنجی مدیران نشان میدهد درباره اینکه پس از وقوع یک خطای بزرگ چه کسی باید پاسخگو باشد، اجماع مشخصی وجود ندارد. پاسخها میان چند گروه اصلی تقسیم شدهاند:
- کارمند استفادهکننده: حدود یکچهارم پاسخدهندگان، فردی را مسئول دانستند که از ابزار هوش مصنوعی استفاده کرده است.
- مدیر مستقیم: سهمی مشابه از شرکتکنندگان، مسئولیت را متوجه مدیر ناظر بر کارمند یا فرایند مربوطه دانستند.
- تیم ارزیابی ریسک: گروهی دیگر معتقد بودند مسئولیت اصلی باید بر عهده تیمی باشد که وظیفه شناسایی و مدیریت خطرهای سازمانی را دارد.
- توسعهدهنده یا تأمینکننده مدل: نزدیک به ۱۰ درصد پاسخدهندگان، شرکت ارائهدهنده فناوری را مسئول معرفی کردند.
- بدون پاسخ مشخص: حدود ۱۰ درصد نیز نتوانستند فرد یا گروه مشخصی را معرفی کنند.
این پراکندگی نشان میدهد بسیاری از سازمانها هنوز چارچوب روشنی برای تقسیم مسئولیت میان کارکنان، مدیران و ارائهدهندگان فناوری ندارند. البته مشخصنبودن یک پاسخ مشترک به این معنا نیست که در هر پرونده حقوقی نمیتوان مسئولیت افراد یا شرکتها را تعیین کرد؛ نتیجه نهایی به شرایط حادثه، قراردادها و قوانین مربوط بستگی دارد.
چرا عاملهای هوش مصنوعی خطرهای تازهای ایجاد میکنند؟
نسل جدید ابزارهای هوش مصنوعی، از محصولات شرکتهایی مانند OpenAI، گوگل و متا، بهتدریج از پاسخگویی به پرسشها فراتر میروند. این سامانهها میتوانند با هویتهای سازمانی مستقل فعالیت کنند، وظایف چندمرحلهای را انجام دهند و برای دستیابی به اهداف مشخص، ساعتها یا حتی چند روز کار کنند.
افزایش استقلال این ابزارها، نظارت بر عملکردشان را دشوارتر میکند. در یک فرایند سنتی، معمولاً کارمند مراحل مختلف کار را انجام میدهد و پیش از اقدام نهایی فرصت بررسی نتیجه را دارد. اما یک عامل هوش مصنوعی ممکن است در صورت دسترسی به سامانههای عملیاتی، چندین اقدام را پشت سر هم انجام دهد و خطای اولیه را به پیامدهای گستردهتری تبدیل کند.
برای مثال، اگر چنین ابزاری به پایگاه داده مشتریان، سامانه پرداخت یا سرویس ارسال ایمیل متصل باشد، یک دستور اشتباه میتواند در مدت کوتاهی تعداد زیادی از کاربران را تحت تأثیر قرار دهد.
دو نمونه از خسارتهای ناشی از دستورهای اشتباه
خطاهای عاملهای هوش مصنوعی لزوماً نتیجه رفتار غیرقابلپیشبینی یا تصمیمگیری پیچیده نیستند. گاهی یک دستور نادرست یا تنظیم اشتباه برای ایجاد خسارت کافی است.
در یکی از نمونههای گزارششده، خطای پرامپت در یک فروشگاه زنجیرهای باعث شد اعلانهای نادرست مربوط به استرداد وجه برای بیش از ۱۸ هزار مشتری ارسال شود. این اتفاق در کمتر از شش ساعت رخ داد.
در نمونهای دیگر، یک پرامپت اشتباه موجب شد قیمت یک گوشی پرچمدار به مدت سه ساعت با تخفیف ۸۵ درصدی ثبت شود. نتیجه این خطا، ثبت بیش از ۷۰۰ سفارش نامعتبر بود که رسیدگی به آنها بر عهده تیم پشتیبانی قرار گرفت.
این نمونهها نشان میدهند اتصال هوش مصنوعی به زیرساختهای عملیاتی، در کنار افزایش سرعت انجام کارها، میتواند دامنه اثر اشتباهها را نیز گسترش دهد. هرچه یک سامانه دسترسی بیشتری به اطلاعات، قیمتگذاری یا ارتباط با مشتریان داشته باشد، کنترل مجوزها و بررسی اقدامات آن اهمیت بیشتری پیدا میکند.
شرکتها هنوز برای خطاهای هوش مصنوعی آماده نیستند
جرمی کورست، شریک شرکت مشاوره GBK Collective و همکار پژوهش مدرسه وارتون، میگوید بسیاری از سازمانها همچنان در حال یادگیری نحوه استفاده از این فناوری هستند. به گفته او، وقتی از مدیران ارشد درباره مسئولیت خطاهای هوش مصنوعی سؤال میشود، یکی از پاسخهای رایج این است که آنها هنوز اساساً به این موضوع فکر نکردهاند.
چنین وضعیتی میتواند فاصله میان سرعت پذیرش فناوری و آمادگی مدیریتی سازمانها را آشکار کند. شرکتها ممکن است ابزارهای هوش مصنوعی را برای کاهش هزینه و افزایش سرعت به کار بگیرند، اما بدون تعیین مسئولیتها، محدودکردن دسترسیها و طراحی سازوکارهای نظارتی، در زمان بروز حادثه با سردرگمی مواجه شوند.
چگونه میتوان مسئولیت خطاهای هوش مصنوعی را مشخص کرد؟
برای کاهش این ابهام، سازمانها میتوانند پیش از واگذاری وظایف حساس به عاملهای هوش مصنوعی، چند اقدام اساسی را در نظر بگیرند:
- تعیین مسئول مشخص: برای هر سامانه و فرایند، فرد یا تیم پاسخگو از قبل معرفی شود.
- محدودکردن دسترسیها: عامل هوش مصنوعی فقط به اطلاعات و ابزارهای ضروری برای انجام وظیفه خود دسترسی داشته باشد.
- تأیید اقدامات حساس: عملیات پرریسک، مانند بازپرداخت مبالغ بالا یا تغییر گسترده قیمتها، پیش از اجرا به تأیید انسان نیاز داشته باشند.
- ثبت سوابق فعالیت: دستورها، تصمیمها و اقدامات سامانه ثبت شوند تا بررسی علت خطا امکانپذیر باشد.
- آمادگی برای توقف اضطراری: شرکتها بتوانند در صورت مشاهده رفتار غیرعادی، فعالیت عامل هوش مصنوعی را سریعاً متوقف کنند.
در نهایت، چالش اصلی فقط ساخت هوش مصنوعی دقیقتر نیست؛ شرکتها باید مشخص کنند چه کسی اختیار تصمیمگیری دارد، چه کسی بر عملکرد سامانه نظارت میکند و در صورت بروز خسارت، مسئولیت چگونه تعیین خواهد شد. تا زمانی که این چارچوبها روشن نباشند، افزایش استقلال عاملهای هوش مصنوعی میتواند ریسکهای عملیاتی و مدیریتی تازهای برای کسبوکارها ایجاد کند.