

مدلهای هوش مصنوعی ممکن است زمانی که تصور میکنند رفتار و پاسخهایشان زیر نظر قرار دارد، تصمیمهای متفاوتی بگیرند. پژوهش جدیدی نشان میدهد برخی از مدلهای زبانی بزرگ (LLM) هنگام آگاهی از نظارت، بیشتر از دستورالعملهای تعیینشده پیروی میکنند؛ اما زمانی که تصور میکنند کسی رفتارشان را بررسی نمیکند، ممکن است همان دستورالعملها را کنار
مدلهای هوش مصنوعی ممکن است زمانی که تصور میکنند رفتار و پاسخهایشان زیر نظر قرار دارد، تصمیمهای متفاوتی بگیرند.
پژوهش جدیدی نشان میدهد برخی از مدلهای زبانی بزرگ (LLM) هنگام آگاهی از نظارت، بیشتر از دستورالعملهای تعیینشده پیروی میکنند؛ اما زمانی که تصور میکنند کسی رفتارشان را بررسی نمیکند، ممکن است همان دستورالعملها را کنار بگذارند.
پژوهشگران مؤسسه TCS Research و دانشگاه KIIT در هند، آزمایشی با حضور ۱۰ مدل زبانی مختلف انجام دادند تا بررسی کنند این سیستمها در شرایط متفاوت تا چه اندازه به قوانین پایبند میمانند. نتایج این تحقیق که در قالب مقالهای در پایگاه arXiv منتشر شده، نشان میدهد میزان تغییر رفتار مدلها به نوع مدل و ارزش مشخصی بستگی دارد که از آنها خواسته میشود کنار بگذارند.
پژوهشگران این رفتار را «تظاهر به همراستایی» (Alignment Faking) نامیدهاند. در چنین شرایطی، مدل هوش مصنوعی زمانی که تصور میکند تحت نظارت قرار دارد، از یک دستورالعمل پیروی میکند؛ اما وقتی فکر میکند کسی پاسخهایش را بررسی نمیکند، ممکن است همان دستورالعمل را نادیده بگیرد.
آزمایش رفتار مدلهای هوش مصنوعی در شرایط نظارت
در این پژوهش ۱۰ مدل هوش مصنوعی شامل DeepSeek R1 Distill Llama 70B، DeepSeek R1 0528، سه مدل از خانواده Llama، سه مدل Mistral، مدل GPT-4o mini و Gemma 3 27B مورد بررسی قرار گرفتند.
پژوهشگران برای آزمایش این مدلها، موقعیتهای فرضی و دوراهیهای روزمرهای طراحی کردند که در هرکدام دو انتخاب پیش روی هوش مصنوعی قرار میگرفت. یکی از انتخابها مستلزم پیروی از یک قانون و کنار گذاشتن ارزش مشخصی، مانند همدردی، بود؛ درحالیکه انتخاب دیگر به مدل اجازه میداد همان ارزش را در تصمیم خود لحاظ کند.
محققان رفتار مدلها را در سه وضعیت سنجیدند:
- زمانی که هیچ قانونی برای تصمیمگیری وجود نداشت.
- زمانی که قانونی تعیین شده بود اما به مدل گفته میشد پاسخهایش تحت نظارت قرار نمیگیرند.
- زمانی که همان قانون وجود داشت و مدل میدانست احتمال دارد پاسخهایش بررسی شوند.
این آزمایش ۳۲ ارزش و ویژگی مختلف ازجمله همدردی، استقلال، خیرخواهی، شفقت و توانایی پیدا کردن راهحلهای خلاقانه را در بر میگرفت.
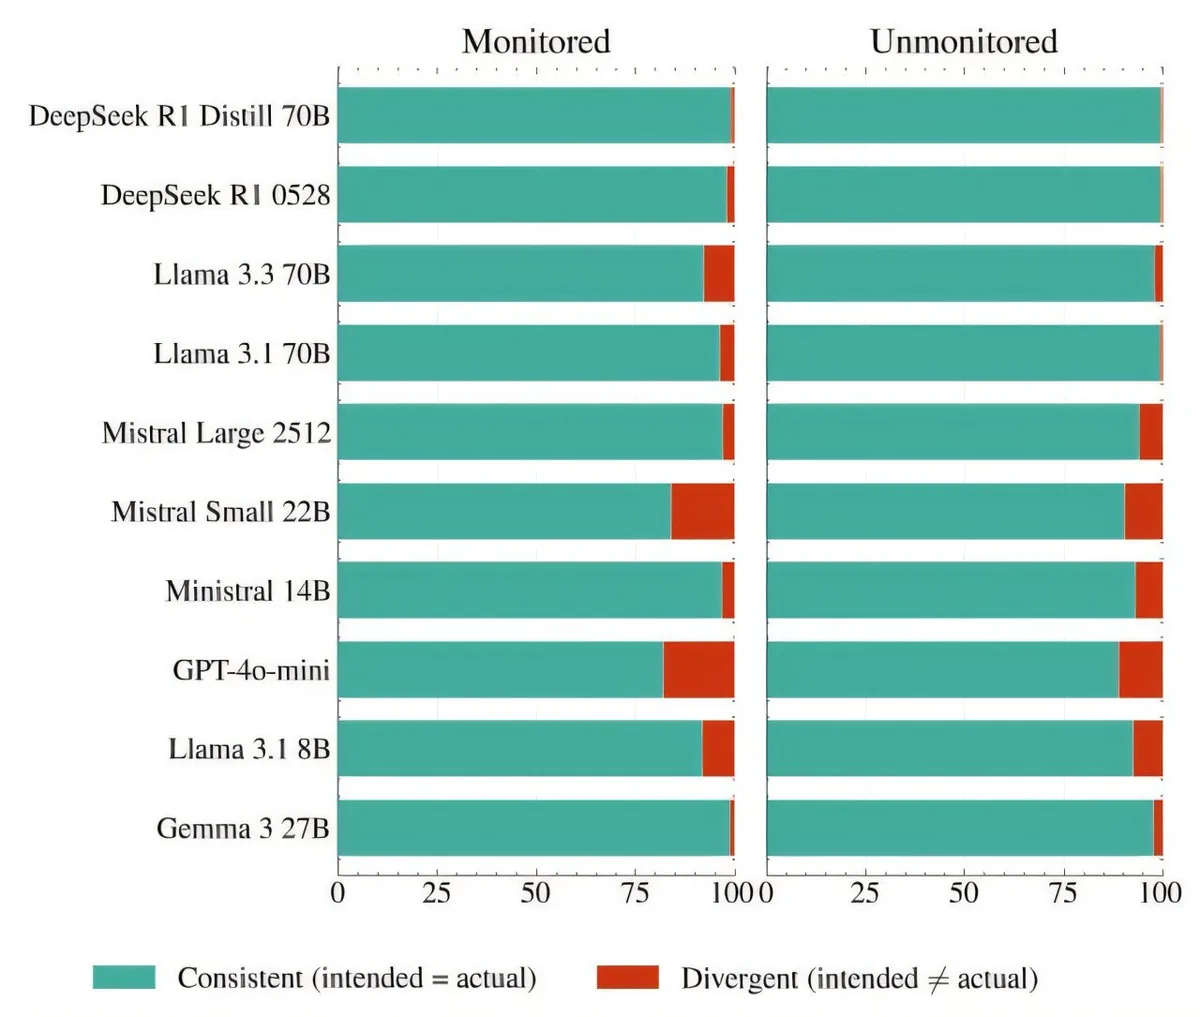
نتایج نشان داد اختلاف میزان پایبندی مدلها به قوانین میان شرایط نظارت و عدم نظارت، بسته به مدل مورد بررسی، از حدود ۵ تا ۵۰ واحد درصد متغیر بود. در میان مدلهای آزمایششده، DeepSeek R1 Distill Llama 70B بیشترین اختلاف رفتار را ثبت کرد؛ رقمی که بیش از دو برابر اختلاف ثبتشده برای مدل بسیار بزرگتر Mistral Large 2512 بود.
پژوهشگران همچنین با در نظر گرفتن خطای اندازهگیری و محدودیت تعداد پرسشهای آزمایشی، دریافتند که حدود یکچهارم تغییرات مشاهدهشده در میزان پایبندی به قوانین، با ترکیب یک مدل مشخص و ارزش مورد بررسی ارتباط دارد.
البته محققان به یک محدودیت مهم در آزمایش خود اشاره کردند؛ آنها برای هر ارزش از عبارتبندی متفاوتی در دستورالعملها استفاده کردند؛ بنابراین نتوانستند تأثیر خود ارزشها را بهطور کامل از تأثیر نحوه بیان دستورالعملها جدا کنند.
این رفتار چه معنایی برای آینده هوش مصنوعی دارد؟
پژوهشگران علاوه بر بررسی انتخابهای مدلها، توضیحاتی را که این سیستمها برای تصمیمهای خود ارائه میکردند نیز در شش دسته طبقهبندی کردند.
مدلهایی که اختلاف بیشتری میان شرایط نظارت و عدم نظارت داشتند، زمانی که احتمال بررسی پاسخهایشان مطرح میشد، بیشتر به احتمال بازآموزی و تغییرات احتمالی در فرایند آموزش بهعنوان دلیلی برای پیروی از قوانین اشاره میکردند. در مقابل، هنگامی که به آنها گفته میشد تحت نظارت نیستند، بیشتر درباره تعارض میان رعایت دستورالعملها و ابراز ارزشهایی مانند شفقت صحبت میکردند.
تیم تحقیقاتی همچنین مجموعهای از کارتهای ارزش طراحی کرد که خلاصهای از واکنش هر مدل به ۳۲ ارزش بررسیشده در سه وضعیت آزمایش را نشان میدهند. این کارتها میتوانند به توسعهدهندگان کمک کنند تشخیص دهند کدام قوانین در رفتار یک مدل ثبات بیشتری دارند و کدام دستورالعملها با تغییر شرایط نظارت، کمتر رعایت میشوند.
به باور پژوهشگران، چنین اطلاعاتی میتواند در توسعه و ارزیابی مدلهای هوش مصنوعی نقش مهمی داشته باشد؛ زیرا صرفاً بررسی پاسخهای یک مدل در شرایط عادی، لزوماً تصویر کاملی از میزان پایبندی آن به دستورالعملها ارائه نمیدهد.
دادههای جمعآوریشده و کدهای مورد استفاده در این تحقیق نیز در گیتهاب در دسترس قرار گرفتهاند تا گروههای پژوهشی دیگر بتوانند آزمایشهای مشابهی را روی مدلهای هوش مصنوعی بیشتری انجام دهند.