

استارتاپ الوریان از مدل هوش مصنوعی Glimpse رونمایی کرده است؛ مدلی که بهجای تکیه صرف بر توصیف متنی تصاویر، میتواند در جریان استدلال بارها به محتوای بصری اصلی بازگردد و بخشهای مختلف آن را بررسی کند. این شرکت مدعی است Glimpse در برخی آزمونهای استدلال بصری از مدلهای پیشرفتهای مانند GPT-۶ Astra عملکرد بهتری دارد.
شرکت Elorian، مستقر در پالو آلتو، روز جمعه ۲۴ مهر ۱۴۰۵ نخستین مدل استدلال بصری خود را در قالب نسخه پیشنمایش پژوهشی عرضه کرد. دسترسی به Glimpse از طریق رابط گفتوگومحور و API امکانپذیر است. الوریان همچنین اعلام کرده که در دور تأمین مالی اولیه، ۵۵ میلیون دلار سرمایه با ارزشگذاری ۳۰۰ میلیون دلاری جذب کرده است.
ایده اصلی توسعه این مدل بر یک محدودیت شناختهشده در هوش مصنوعی چندوجهی متمرکز است: توانایی تحلیل تصاویر و ویدیوها همیشه به معنای درک دقیق روابط بصری و استدلال درباره آنها نیست. الوریان میخواهد با تغییر شیوه تعامل مدل با تصویر، این فاصله را کاهش دهد.
Glimpse چگونه تصاویر را تحلیل میکند؟
در بسیاری از مدلهای چندوجهی، تصویر ابتدا پردازش و به مجموعهای از توکنها تبدیل میشود؛ سپس مدل با تکیه بر بازنمایی بهدستآمده، درباره محتوای آن پاسخ میدهد. در مقابل، Glimpse میتواند در طول فرایند استدلال دوباره به تصویر اصلی مراجعه کند، بخش مشخصی از آن را برش دهد، فریمهایی از یک ویدیو استخراج کند یا برای اندازهگیری و مقایسه اطلاعات بصری کد اجرا کند.
الوریان این روش را «فضای چرکنویس بصری» مینامد. هدف این سازوکار آن است که مدل بتواند فرضیههای خود را با مراجعه مجدد به شواهد تصویری بررسی کند، نه اینکه صرفاً به برداشت اولیه از تصویر متکی بماند.
این رویکرد برای کارهایی مانند خواندن نمودارهای پیچیده، تشخیص روابط میان نمادها، بررسی دستورالعملهای تصویری و تحلیل ویدیوها اهمیت دارد؛ وظایفی که ممکن است به مشاهده دقیق جزئیات یا مقایسه چند بخش از تصویر نیاز داشته باشند.
تجربهای که ایده ساخت Glimpse را شکل داد
اندرو دای، پژوهشگر سابق گوگل دیپمایند و مدیرعامل الوریان، در گفتوگو با تککرانچ توضیح داده است که یکی از نمونههای ملموس محدودیت مدلهای موجود را هنگام بازی رومیزی با دوستانش مشاهده کرد.
او از صفحه بازی عکس گرفت و از یک مدل هوش مصنوعی خواست مشخص کند کدام بازیکن در آستانه پیروزی قرار دارد؛ اما مدل نتوانست پاسخ مناسبی ارائه کند. به گفته دای، بسیاری از بازیهای رومیزی بر نمادها و قواعد بصری اختصاصی تکیه دارند و درک وضعیت بازی بدون توضیحات متنی برای انسان نسبتاً ساده است، اما مدلهای هوش مصنوعی ممکن است در تفسیر شهودی این نشانهها مشکل داشته باشند.
دای برای توضیح این محدودیت به دستورالعملهای تصویری مونتاژ محصولات ایکیا اشاره میکند؛ راهنماهایی که افراد میتوانند با اتکا به تصاویر و بدون نیاز به متن فراوان، مراحل سرهمکردن یک وسیله را دنبال کنند. از دید او، دستیابی به چنین تواناییهایی یکی از اهداف مهم استدلال بصری در هوش مصنوعی است.
تفاوت Glimpse با مدلهای چندوجهی دیگر
ایده مراجعه مجدد به تصویر کاملاً جدید نیست. OpenAI در سال ۲۰۲۵ قابلیتهایی برای برش و بزرگنمایی تصاویر هنگام استدلال به مدلهای سری o اضافه کرده بود. تفاوت مورد تأکید الوریان این است که Glimpse از ابتدا با محوریت همین نوع تعامل بصری طراحی شده است.
این شرکت میگوید مدل را تیمی کوچک با استفاده از چند صد پردازنده گرافیکی آموزش داده و اندازه آن در مقایسه با برخی مدلهای پیشرفته مورد ارزیابی، بهمراتب کوچکتر است. اگر این ادعاها در آزمونهای مستقل تأیید شوند، Glimpse میتواند نمونهای از تلاش برای بهبود استدلال بصری بدون اتکا به مدلهای بسیار بزرگ باشد.
بااینحال، نتایج اعلامشده از سوی خود شرکت را نباید معادل برتری قطعی در تمام کاربردها دانست. عملکرد مدل به نوع آزمون، روش ارزیابی و پیچیدگی وظیفه بستگی دارد و برای مقایسه دقیق، بررسیهای مستقل ضروری است.
هزینه استفاده از Glimpse چقدر است؟
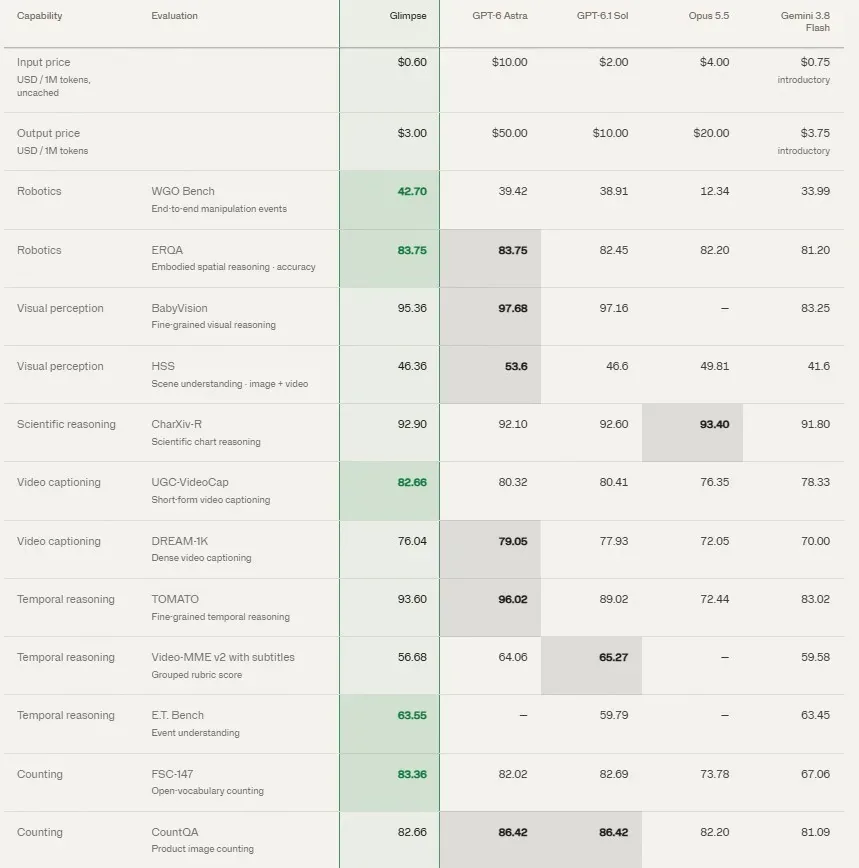
الوریان قیمت استفاده از مدل را برای هر یک میلیون توکن ورودی ۰٫۶۰ دلار و برای هر یک میلیون توکن خروجی ۳ دلار اعلام کرده است.
بر اساس مقایسه ارائهشده از سوی شرکت، هزینه Glimpse از برخی مدلهای میانرده مانند Sonnet و Sol کمتر است، اما در مقایسه با مدلهای سبکتر نظیر Haiku و Luna قیمت بالاتری دارد. هزینه نهایی استفاده نیز به حجم ورودی، خروجی و نوع پردازش موردنیاز وابسته خواهد بود.
الوریان همچنین مدعی است Glimpse در تحلیل نمودارهای علمی و تولید توضیحات کوتاه برای ویدیوها، در برخی ارزیابیها از GPT-۶ Astra پیشی گرفته و در شماری دیگر از وظایف استدلال بصری نیز نتایج رقابتی ثبت کرده است.
هدف بعدی الوریان؛ از تحلیل تصویر تا کنترل رباتها
شرکتهایی که با حجم بالایی از ویدیو و دادههای تصویری سروکار دارند، از مشتریان اولیه موردنظر الوریان هستند. این گروه شامل شرکتهای رباتیک، آزمایشگاههای علمی، رسانهها و کسبوکارهای فعال در صنایع خلاق میشود.
برنامه بلندمدت شرکت تنها به شناسایی اشیا یا توضیح صحنهها محدود نیست. الوریان میخواهد توانایی مدل را به ساخت بازنمایی از محیط و انتخاب اقدام مناسب گسترش دهد؛ قابلیتی که در آینده میتواند برای کنترل مستقیم رباتها نیز به کار گرفته شود.
اندرو دای هدف شرکت برای سال آینده را ساخت «بهترین مدل استدلال بصری جهان» عنوان کرده است؛ مدلی که در آزمونهای مختلف این حوزه عملکرد پیشتازی داشته باشد. تحقق این هدف به نتایج ارزیابیهای مستقل، توانایی مدل در شرایط واقعی و میزان موفقیت آن در کاربردهای عملی بستگی خواهد داشت.