

جمنای ۴ کربن در بنچمارک GDPx عملکردی نزدیک به کلاد اپوس ۵.۵ دارد، اما هزینه اجرای وظایف با آن کمتر از یکسوم است.
نتایج بنچمارک GDPx نشان میدهد جمنای ۴ کربن گوگل با وجود فاصله اندک از کلاد اپوس ۵.۵ در امتیاز کلی، هزینه اجرای بسیار کمتری دارد. بر اساس این ارزیابی، میانگین هزینه انجام هر وظیفه با مدل گوگل کمی بیشتر از ۱۶ دلار است؛ درحالیکه این رقم برای مدل آنتروپیک به حدود ۵۱ دلار میرسد.
این نتایج نشان میدهند رقابت میان مدلهای پیشرفته هوش مصنوعی تنها به کسب بالاترین امتیاز محدود نیست و هزینه پردازش نیز به یکی از معیارهای مهم انتخاب تبدیل شده است. جمنای ۴ کربن اگرچه صدرنشین ارزیابی نیست، اما نسبت عملکرد به هزینه آن میتواند برای کاربران حرفهای و کسبوکارها جذاب باشد.
بنچمارک GDPx چه چیزی را اندازهگیری میکند؟
معیار GDPx برای مقایسه مدلهای پیشرفته شرکتهایی مانند گوگل، OpenAI، آنتروپیک و متا طراحی شده است. این بنچمارک ۲۰۶ وظیفه تخصصی را در حوزههای مختلف بررسی میکند تا تصویری جامعتر از توانایی مدلها در انجام فعالیتهای حرفهای ارائه دهد.
موضوعات این آزمون تنها به تولید محتوا و پاسخگویی عمومی محدود نمیشوند و حوزههایی مانند امور مالی، علم مواد، امنیت سایبری، مهندسی نرمافزار، حقوق و زیستشناسی را نیز در بر میگیرند. به همین دلیل، نتایج آن میتوانند برای ارزیابی عملکرد مدلها در کاربردهای تخصصی اطلاعات مفیدی فراهم کنند.
در رتبهبندی اصلی، کلاد اپوس ۵.۵ از آنتروپیک در جایگاه نخست قرار گرفت و جمنای ۴ کربن با اختلافی نسبتاً کم در رتبه بعدی ایستاد. بااینحال، مقایسه هزینهها تفاوت چشمگیری میان این دو مدل نشان میدهد.
هزینه پردازش جمنای ۴ کربن کمتر از یکسوم کلاد است
طبق دادههای منتشرشده، اجرای هر وظیفه با کلاد اپوس ۵.۵ بهطور میانگین حدود ۵۱ دلار هزینه دارد. در مقابل، این رقم برای جمنای ۴ کربن کمی بیشتر از ۱۶ دلار گزارش شده است. به این ترتیب، مدل گوگل با هزینهای کمتر از یکسوم رقیب خود، عملکردی نزدیک به آن ارائه میدهد.
این اختلاف در پروژههایی که به اجرای مکرر وظایف یا پردازش حجم زیادی از دادهها نیاز دارند، اهمیت بیشتری پیدا میکند. برای مثال، شرکتهایی که از مدلهای هوش مصنوعی در سامانههای سازمانی استفاده میکنند، میتوانند با انتخاب گزینهای کمهزینهتر، مخارج پردازشی خود را کاهش دهند؛ البته به شرط آنکه کیفیت خروجی برای نیازهایشان کافی باشد.
GPT-۶ Astra از OpenAI نیز در این ارزیابی پایینتر از دو مدل یادشده قرار گرفت. میانگین هزینه اجرای هر وظیفه با این مدل حدود ۵۴ دلار اعلام شده است؛ رقمی که از هزینه استفاده از کلاد اپوس ۵.۵ و جمنای ۴ کربن بیشتر است.
در نتیجه، کلاد اپوس ۵.۵ بالاترین امتیاز کلی را به دست آورده، اما جمنای ۴ کربن از نظر نسبت عملکرد به هزینه وضعیت متفاوتی دارد. GPT-۶ Astra نیز با وجود هزینه بیشتر، در رتبه پایینتری از این دو مدل قرار گرفته است.
تغییر معیارهای ارزیابی، رتبهبندی مدلها را جابهجا کرد
SemiAnalysis برای بررسی تأثیر برخی حوزههای تخصصی بر نتایج، نسخه دیگری از رتبهبندی GDPx را نیز منتشر کرده است. در این نسخه، وظایف مرتبط با امنیت سایبری، زیستشناسی و همترازی هوش مصنوعی از ارزیابی کنار گذاشته شدند.
حذف این سه حوزه باعث تغییر جایگاه مدلهای برتر شد و GPT-۶ Astra را به رتبه نخست رساند. در رتبهبندی جدید، GPT-۶.۱ Sol و کلاد اپوس ۵.۵ نیز بالاتر از جمنای ۴ کربن قرار گرفتند. پژوهشگران SemiAnalysis اعلام کردهاند که این نتایج با برداشت آنها از توانایی نسبی مدلها هماهنگی بیشتری دارد.
یکی از توضیحات مطرحشده برای این تفاوت، تأثیر محدودیتهای ایمنی مدلها است. سازوکارهای محافظتی در برخی مدلهای کلاد و GPT ممکن است مانع انجام کامل بعضی درخواستهای مرتبط با امنیت سایبری، زیستشناسی یا همترازی هوش مصنوعی شوند.
بنابراین، امتیاز نهایی در چنین آزمونهایی لزوماً فقط توانایی فنی مدل را منعکس نمیکند و میزان محدودیت آن در پاسخگویی به درخواستهای حساس نیز میتواند بر نتیجه تأثیر بگذارد.
عملکرد مدلهای قبلی گوگل و رقابت در امنیت سایبری
مدل جمنای ۴ آرگون، نسخه مرزی قبلی گوگل، در هر دو رتبهبندی جایگاه هشتم را به دست آورد. این مدل بالاتر از Muse Wonder متعلق به متا و پایینتر از Wonder Full قرار گرفت.
از نظر هزینه نیز آرگون تنها اندکی ارزانتر از جمنای ۴ کربن بود. با توجه به جایگاه بهتر مدل جدید گوگل، نتایج نشان میدهند کربن در مقایسه با نسل قبلی خود نسبت عملکرد به هزینه بهتری ارائه میکند.
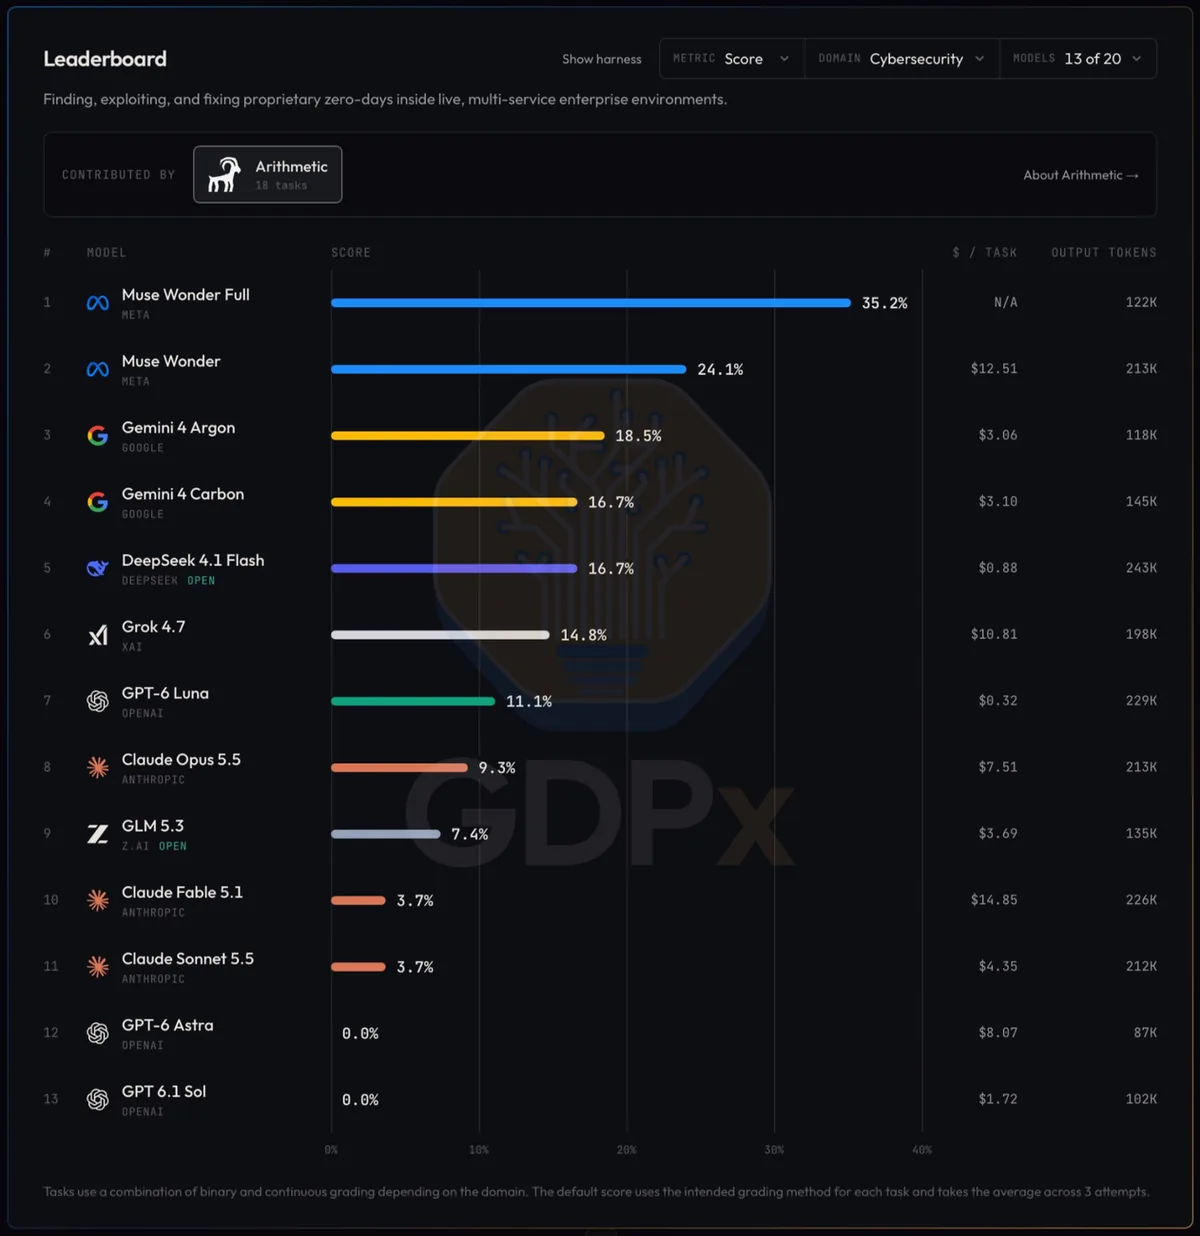
بااینحال، بررسی اختصاصی حوزه امنیت سایبری تصویر متفاوتی از رقابت مدلها به نمایش میگذارد. هر دو مدل گوگل در این بخش امتیاز بالاتری از مدلهای OpenAI و آنتروپیک کسب کردند، اما همچنان پایینتر از خانواده Muse متا قرار گرفتند.
بر اساس دادههای GDPx، مدلهای Muse در وظایف مرتبط با امنیت سایبری با اختلاف قابلتوجهی بهترین عملکرد را ثبت کردهاند. این موضوع نشان میدهد برتری یک مدل هوش مصنوعی میتواند به حوزه کاربرد و نوع وظایف مورد ارزیابی وابسته باشد و نمیتوان صرفاً با تکیه بر یک رتبهبندی، عملکرد آن را در تمام زمینهها تعیین کرد.