

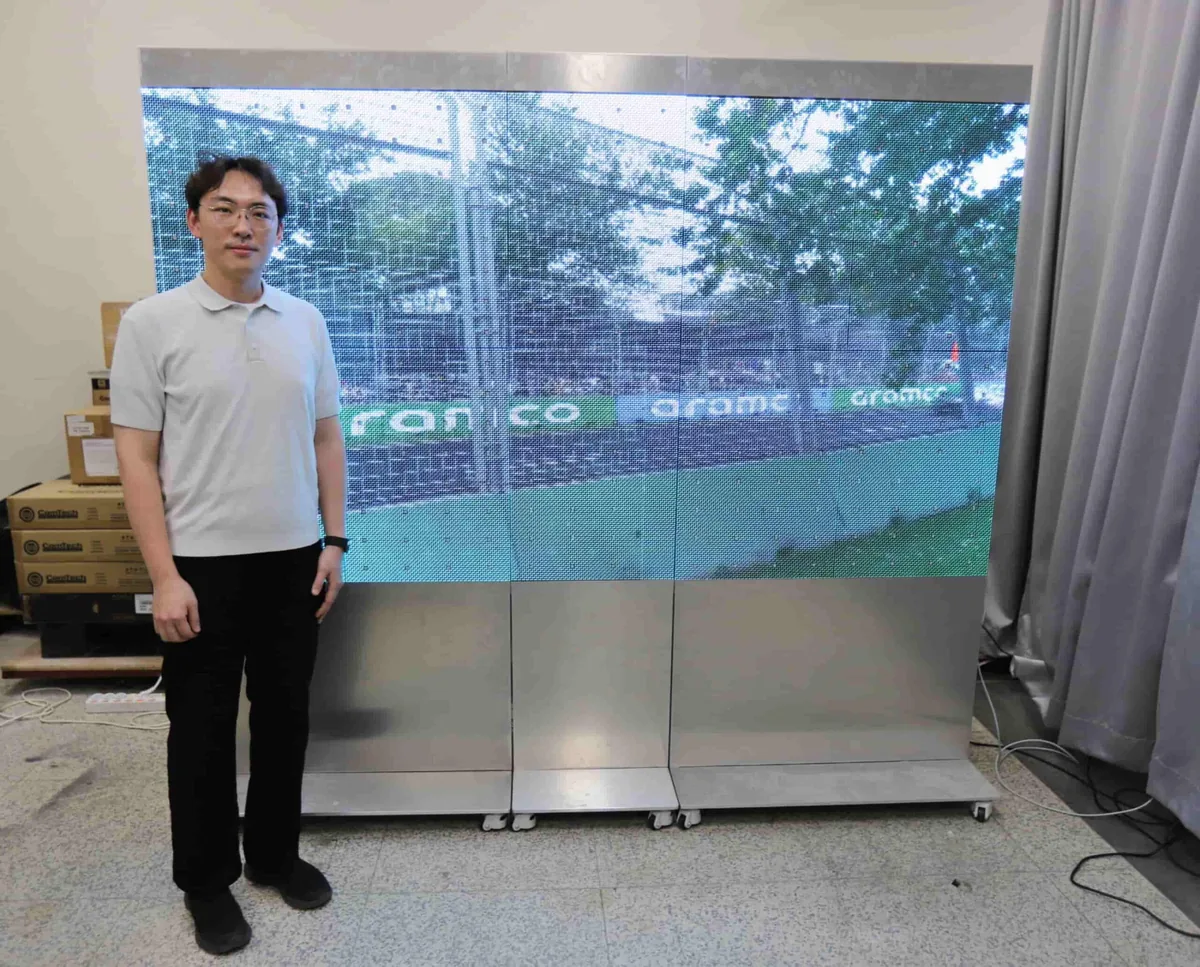
پژوهشگران کره جنوبی فناوری جدیدی توسعه دادهاند که میتواند تجربه تماشای تلویزیون را واقعیتر کند؛ این فناوری با استفاده از موتورهای سیمپیچ صوتی (Voice Coil Motors) باعث میشود صدا دقیقاً از همان نقطهای از نمایشگر شنیده شود که اتفاق موردنظر در آن رخ میدهد. به این ترتیب، اگر فردی در گوشه سمت چپ نمایشگر صحبت
پژوهشگران کره جنوبی فناوری جدیدی توسعه دادهاند که میتواند تجربه تماشای تلویزیون را واقعیتر کند؛ این فناوری با استفاده از موتورهای سیمپیچ صوتی (Voice Coil Motors) باعث میشود صدا دقیقاً از همان نقطهای از نمایشگر شنیده شود که اتفاق موردنظر در آن رخ میدهد.
به این ترتیب، اگر فردی در گوشه سمت چپ نمایشگر صحبت کند، صدای او نیز از همان قسمت و تقریباً از محل قرارگیری دهانش پخش خواهد شد. پژوهشگران مؤسسه ماشینآلات و مواد کره (KIMM) این فناوری را با هدف برطرفکردن یکی از مشکلات قدیمی نمایشگرها توسعه دادهاند: فاصله مکانی میان تصویر و صدا.
در تلویزیونها، مانیتورها و حتی گوشیهای هوشمند، تصویر از نمایشگر پخش میشود، اما صدا معمولاً از بلندگوهای داخلی یا تجهیزات صوتی جداگانه به گوش میرسد. این موضوع با تجربه طبیعی انسان از محیط اطراف تفاوت دارد؛ زیرا در دنیای واقعی انتظار داریم صدا را از همان نقطهای بشنویم که منبع آن قرار دارد. برای مثال، وقتی فردی در سمت راست ما صحبت میکند، مغز میتواند با کمک جهت صدا تشخیص دهد که چه کسی در حال حرفزدن است.
فناوریهایی مانند صدای استریو و فراگیر (Surround Sound) تلاش کردهاند این تجربه را شبیهسازی کنند، اما همچنان به بلندگوهایی متکی هستند که در اطراف محل تماشا قرار میگیرند. به همین دلیل، هماهنگکردن دقیق موقعیت صدا با اتفاقات روی نمایشگرهای بزرگ همچنان چالشبرانگیز محسوب میشود.
نمایشگری که خودش صدا تولید میکند
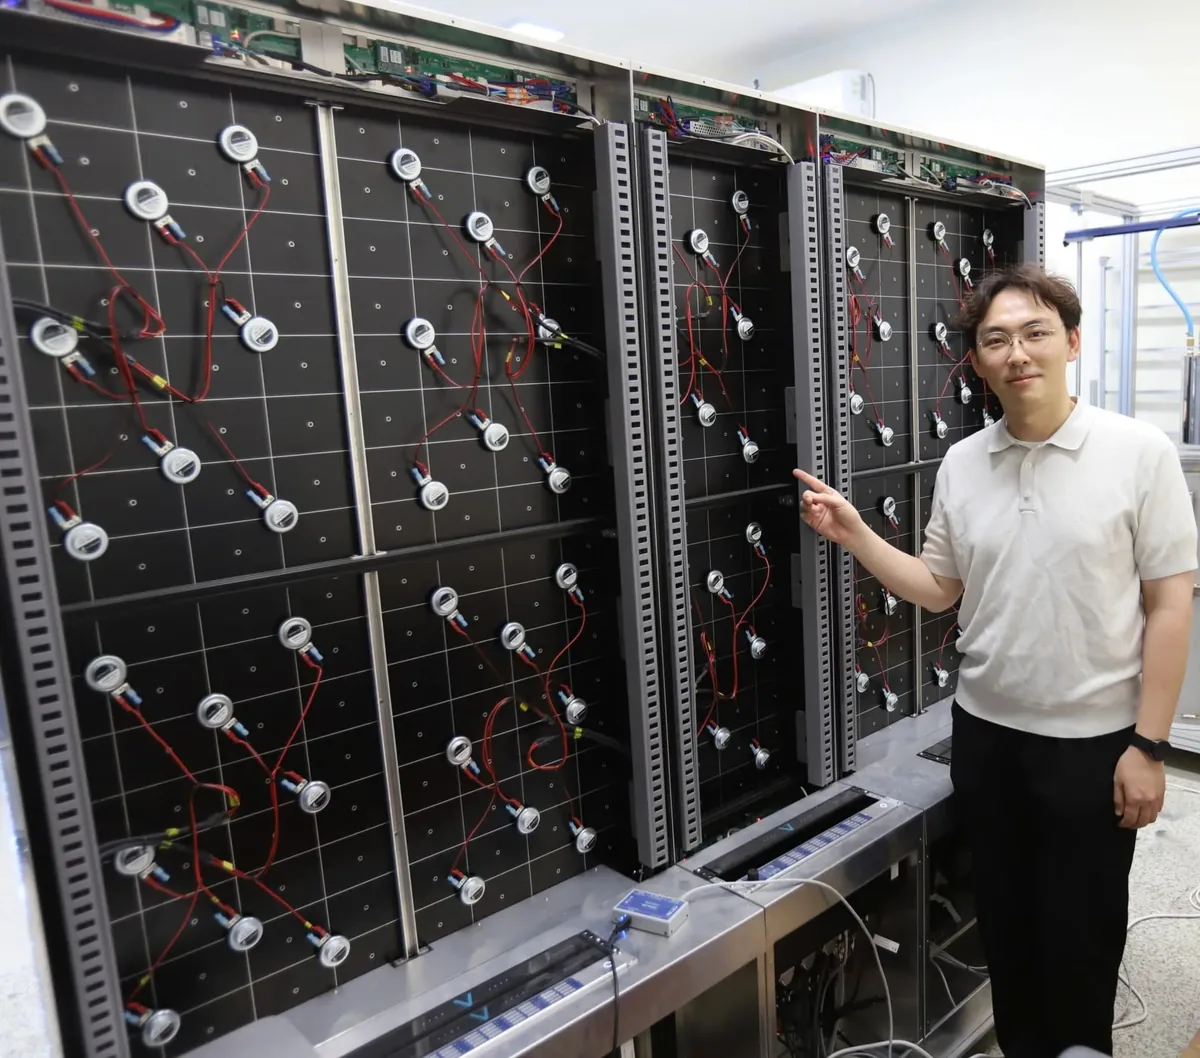
پژوهشگران KIMM برای حل این مشکل سراغ فناوریای رفتهاند که بهجای استفاده از بلندگوهای جداگانه، خود پنل نمایشگر را به منبع تولید صدا تبدیل میکند. در این روش، محرکهای لرزشی متعددی در پشت نمایشگر قرار میگیرند و با ایجاد ارتعاش در بخشهای مشخصی از پنل، امواج صوتی تولید میکنند.
البته فناوریهای مشابه پیش از این نیز وجود داشتهاند؛ برخی بلندگوهای مبتنی بر لرزش پنل از محرکهایی استفاده میکنند که نمایشگر را به ارتعاش درمیآورند تا صدا تولید شود. تفاوت اصلی فناوری جدید کره جنوبی در این است که میتواند محل تولید صدا را بهصورت لحظهای تغییر دهد و آن را با حرکت اشیا یا افراد روی نمایشگر هماهنگ کند.
برای ساخت نمونه اولیه، پژوهشگران نمایشگری تقریباً ۱۰۰ اینچی طراحی کردند که از یک لایه شفاف LED نصبشده روی پنل آلومینیومی تشکیل شده است. در پشت این مجموعه نیز ۸۰ موتور سیمپیچ صوتی (VCM) قرار گرفتهاند؛ این موتورها محرکهای الکترومغناطیسی هستند که در واکنش به سیگنالهای الکتریکی به جلو و عقب حرکت میکنند. حرکت آنها پنل را به لرزش درمیآورد و باعث میشود نمایشگر با فشاردادن هوای اطراف، امواج صوتی تولید کند؛ درست مانند دیافراگم لرزان یک بلندگوی معمولی.
چگونه صدا در نقطه مشخصی از نمایشگر تولید میشود؟
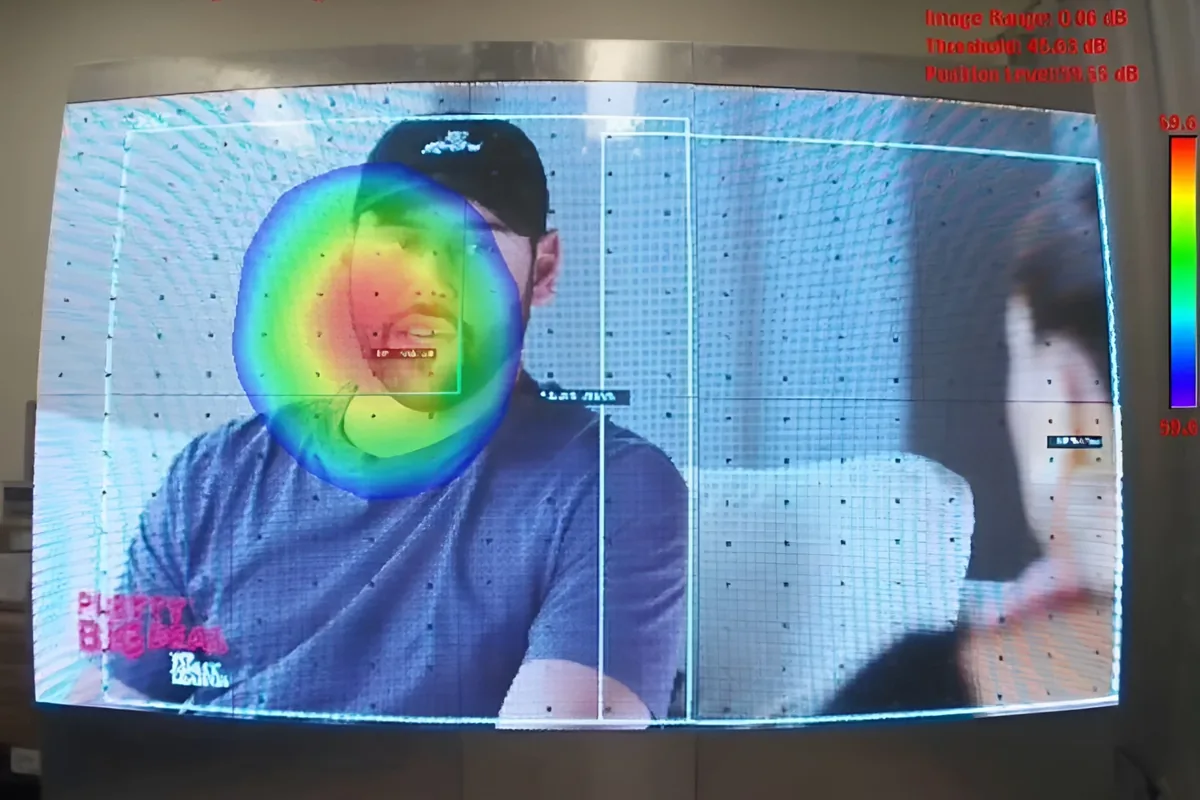
یکی از دشواریهای اصلی این فناوری، کنترل دقیق محل انتشار صداست؛ ارتعاش ایجادشده توسط هر موتور لزوماً در همان نقطه باقی نمیماند و میتواند در سراسر پنل جامد پخش شود. همچنین ارتعاش موتورهای مختلف ممکن است با یکدیگر تداخل داشته باشد و یکدیگر را تقویت یا خنثی کند. بنابراین، روشنکردن موتوری که به محل موردنظر نزدیکتر است، لزوماً باعث نمیشود صدا فقط از همان قسمت نمایشگر شنیده شود.
پژوهشگران برای حل این مشکل ابتدا واکنش بخشهای مختلف پنل به ارتعاش محرکها را بررسی کردند. سپس با استفاده از یک روش ریاضی به نام شبهمعکوس مور-پنروز (Moore-Penrose Pseudoinverse)، سیگنالهای ولتاژ موردنیاز هر موتور را محاسبه کردند تا ارتعاشها در ناحیه مشخصی از نمایشگر متمرکز شوند.
به بیان ساده، این سامانه بهجای فعالکردن یک موتور بهتنهایی، چندین موتور را بهصورت هماهنگ کنترل میکند تا میدان ارتعاشی موردنظر ایجاد شود. با تغییر ترکیب سیگنالهای ارسالی به موتورها، محل انتشار صدا نیز میتواند همزمان با حرکت منبع صوتی در تصویر جابهجا شود.
بااینحال، محاسبه ترکیب مناسب سیگنالها در لحظه کار سادهای نیست؛ ارتعاشهای منتشرشده در پنل ممکن است یکدیگر را تقویت یا خنثی کنند و برخی موتورها نیز در انتقال ارتعاش به نواحی مشخص عملکرد بهتری دارند. این عوامل میتوانند محاسبات را ناپایدار کنند؛ بهخصوص زمانی که سامانه باید با حرکت یک جسم در تصویر، مرتباً موقعیت انتشار صدا را تغییر دهد.
تیم پژوهشی برای رفع این مشکل الگوریتمی با نام تحریک انتخابی (Selective Excitation) توسعه داده است که موتورهای دارای عملکرد ضعیف در انتقال ارتعاش را از محاسبات کنار میگذارد. آنها همچنین روشی برای اتصال روان سیگنالهای صوتی متوالی طراحی کردهاند تا هنگام تغییر محل انتشار صدا، وقفهها و نویزهای ناخواسته به حداقل برسند.
هوش مصنوعی موقعیت منبع صدا را تشخیص میدهد
یکی دیگر از قابلیتهای مهم این فناوری، استفاده از هوش مصنوعی برای تشخیص و جداسازی منابع صوتی است. پژوهشگران این سامانه را به فناوریهای مبتنی بر هوش مصنوعی مجهز کردهاند تا بتواند تشخیص دهد هر صدا از کدام بخش تصویر میآید و آن را از میان صداهای مختلف جدا کند.
برای مثال، اگر چند نفر همزمان در صحنهای حضور داشته باشند، هوش مصنوعی میتواند محل قرارگیری فردی را که صحبت میکند تشخیص دهد و صدای او را از همان قسمت نمایشگر پخش کند. به این ترتیب، دیگر نیازی نیست کاربر بهصورت دستی محل انتشار هر صدا را مشخص کند.
آزمایشهای انجامشده روی نمونه اولیه نشان دادند که این سامانه در انتخاب نواحی موردنظر برای انتشار صدا به دقت ۹۹.۹ درصد دست یافته است. همچنین اختلاف دامنه ارتعاش میان بخشهای فعال و غیرفعال نمایشگر به حداکثر ۳۵ دسیبل رسید؛ نتیجهای که نشان میدهد پژوهشگران توانستهاند ارتعاشها را در نواحی مشخصی متمرکز و در سایر قسمتها تا حد زیادی مهار کنند.
آزمایشهای انجامشده با دوربین آکوستیک نیز تأیید کردند که محل انتشار صدا میتواند حرکت اشیا در نمایشگر را دنبال کند. این پژوهش که در نشریه Journal of Mechanical Science and Technology منتشر شده، توانایی سامانه در متمرکزکردن میدان ارتعاشی را در محدوده فرکانسهای پایین و متوسط، یعنی کمتر از ۵۰۰ هرتز، نشان میدهد.
کاربرد فناوری جدید فراتر از تلویزیون خواهد بود
پژوهشگران برای سازگارکردن این فناوری با نمایشگرهایی در اندازههای مختلف، از طراحی ماژولار مبتنی بر شبکه استفاده کردهاند. در این ساختار، ماژولهای نمایشگر را میتوان با توجه به اندازه موردنیاز به یکدیگر متصل کرد یا از هم جدا ساخت؛ بنابراین، فناوری مذکور میتواند در تلویزیونهای خانگی، نمایشگرهای LED بزرگ و تابلوهای تبلیغاتی دیجیتال به کار گرفته شود.
تیم پژوهشی همچنین نشان داده است که فعالکردن همزمان چند ماژول میتواند جلوههای صوتی فرکانس پایین مشابه یک سابووفر بزرگ ایجاد کند. این قابلیت میتواند در کنار هماهنگی دقیق صدا و تصویر، تجربه تماشای محتوا را فراگیرتر کند.
البته کاربردهای احتمالی این فناوری به تلویزیون محدود نمیشود. نمایشگرهای خودرو، آثار هنری چندرسانهای، اجراهای زنده و نمایشگاهها نیز میتوانند از این فناوری بهره ببرند.
دونگجون کیم (Dongjoon Kim)، پژوهشگر ارشد مرکز تحقیقات همگرایی AX در مؤسسه KIMM، درباره برنامههای آینده این پروژه گفت:
قصد داریم این فناوری را به نمایشگرهای ماژولار متشکل از کاشیهای LED گسترش دهیم و آن را به فناوری محوری نسل بعدی تبدیل کنیم که در طیف گستردهای از کاربردهای نمایشگر قابل استفاده باشد.
با وجود نتایج امیدوارکننده، هنوز مشخص نیست این فناوری تا چه اندازه میتواند با قدرت و عمق صدای سیستمهای صوتی اختصاصی مجهز به سابووفر رقابت کند. تولید جلوههای فرکانس پایین مشابه یک سابووفر بزرگ لزوماً به معنای دستیابی به کیفیت کلی، توان خروجی و گستره فرکانسی سیستمهای صوتی حرفهای نیست.
بنابراین، احتمالاً این فناوری در آینده نزدیک جایگزین کامل سیستمهای صوتی مستقل نخواهد شد؛ اما میتواند یکی از مشکلات مهم تجربه تماشای نمایشگرهای بزرگ را برطرف کند. البته این ناهماهنگی مکانی در نمایشگرهای کوچک چندان محسوس نیست، زیرا مغز انسان معمولاً میتواند اختلاف میان محل تصویر و منبع صدا را جبران کند.