

شرکت توفا لبز (Tufa Labs) با استفاده از مدل هوش مصنوعی خودآموز TufaZip موفق شده یک گیگابایت از اطلاعات ویکیپدیا را بدون حذف حتی یک بیت از دادهها، به فایلی با حجم ۱۰۵.۳۹ مگابایت تبدیل کند. این روش بهجای استفاده از مدلهای دستساز و سنتی، از یک مدل ترنسفورمر با ۱۶۳ میلیون پارامتر برای پیشبینی
شرکت توفا لبز (Tufa Labs) با استفاده از مدل هوش مصنوعی خودآموز TufaZip موفق شده یک گیگابایت از اطلاعات ویکیپدیا را بدون حذف حتی یک بیت از دادهها، به فایلی با حجم ۱۰۵.۳۹ مگابایت تبدیل کند.
این روش بهجای استفاده از مدلهای دستساز و سنتی، از یک مدل ترنسفورمر با ۱۶۳ میلیون پارامتر برای پیشبینی دادهها بهره میبرد. البته فشردهسازی یا بازگشایی چنین فایلی به دو پردازنده گرافیکی انویدیا B200 نیاز دارد و انجام هرکدام از این فرایندها حدود یک هفته زمان میبرد. این دستاورد در میان روشهای ثبتشده در بنچمارک Large Text Compression Benchmark، کوچکترین حجم خروجی را در اختیار دارد که صرفا از یک شبکه عصبی بهعنوان موتور پیشبینی استفاده میکند.
تامی هی، توسعهدهنده TufaZip، اعلام کرده که نسخه بهینهشده این ابزار توانسته یک گیگابایت از ویکیپدیا را به ۱۰۵.۳۹ مگابایت کاهش دهد. این نسخه در کنار فایل فشرده، یک مدل اولیه از پیش آموزشدیده با حجم ۴.۳۳ مگابایت نیز دارد که با دقت پایینتر یا بهصورت کوانتیزهشده ذخیره شده تا فضای کمتری اشغال کند. وجود این مدل اولیه برای بازگشایی فایل ضروری است.
مدل اصلی از معماری ترنسفورمر ۱۲ لایه استفاده میکند؛ به این معنا که هر پیشبینی از ۱۲ مرحله عبور خواهد کرد. مدل اولیه فقط دو لایه آموزشدیده را در خود نگه میدارد و هنگام اجرای مدل کامل، این دو لایه بارها کپی میشوند تا ساختار ۱۲ لایهای شکل بگیرد. هر نسخه کپیشده نیز فرایند یادگیری مستقل خود را ادامه میدهد.
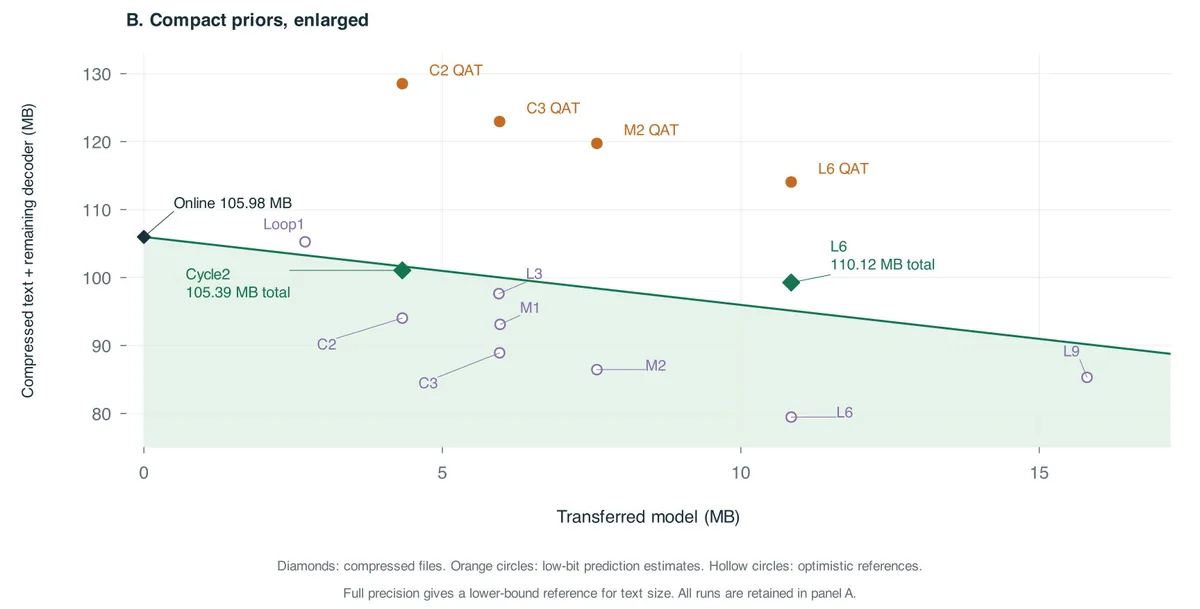
نمودار منتشرشده از سوی توفا لبز، حجم فایل فشرده و مدل موردنیاز برای بازگشایی آن را در مجموعه داده enwik9 مقایسه میکند. در این نمودار، نسخه Cycle2 با حجم نهایی ۱۰۵.۳۹ مگابایت، حتی از معیار پایه آنلاین با حجم ۱۰۵.۹۸ مگابایت نیز عملکرد بهتری دارد. نسخه L۶ نیز به حجم ۱۱۰.۱۲ مگابایت رسیده است.
سازوکار فشردهسازی با هوش مصنوعی خودآموز
TufaZip برخلاف چتباتهای معمولی یا سرویسهای هوش مصنوعی ابری، یک مدل زبانی مستقل محسوب میشود که هنگام اجرا و در لحظه یاد میگیرد. نکته مهم این فناوری، بدون اتلاف بودن فرایند فشردهسازی است؛ بنابراین هیچ بخشی از اطلاعات اصلی هنگام فشردهسازی یا بازگشایی از بین نمیرود. برای تضمین این ویژگی، تمام بهروزرسانیهای مدل پیشبینی باید کاملا قطعی و قابل تکرار باشند.
آموزش این سیستم در دو مرحله انجام میگیرد. ابتدا مدل اولیهای با ۳۴ میلیون پارامتر، پیش از آغاز عملیات فشردهسازی و بهصورت آفلاین آموزش میبیند. سپس مدل کامل به شکل آنلاین شروع به یادگیری میکند؛ به این صورت که هر توکن را پیشبینی کرده و پس از آن با همان داده آموزش میبیند. هنگام بازگشایی فایل نیز همین مراحل دقیقا تکرار میشوند و مدل همزمان با بازسازی متن، دوباره شکل میگیرد.
به همین دلیل، در محاسبه حجم نهایی فایل فقط باید متن فشردهشده، برنامه بازگشایی و فایلهای ضروری آن، از جمله مدل اولیه، در نظر گرفته شوند. مدل کامل آموزشدیده جزو حجم ذخیرهسازی نهایی محسوب نمیشود.
توفا لبز تأکید دارد که TufaZip برخلاف ۱۲ روش برتر دیگر در این بنچمارک، از هیچ مدل فشردهسازی سنتی و دستسازی در کنار شبکه عصبی استفاده نمیکند. سایر روشهای بالاتر از آن، معمولا ترکیبی از ترنسفورمر و مدلهای مهندسیشده سنتی هستند.
نسخه اولیه TufaZip که تمام فرایند یادگیری را بهصورت آنلاین انجام میداد، هنگام ثبت در اوایل سپتامبر رتبه دوم را به دست آورد. نسخه جدید با حجم ۱۰۵.۳۹ مگابایت نیز طبق بهروزرسانی ۱۹ نوامبر بنچمارک، در جایگاه سیزدهم قرار گرفته است. البته باید توجه داشت که این آزمایش صرفا به فشردهسازی متن اختصاص دارد و شامل فایلهای تصویری، صوتی یا ویدئویی نمیشود.
هزینه سنگین اجرای TufaZip و مقایسه با رقبا
با وجود جذابیت این دستاورد، TufaZip فعلا یک پروژه پژوهشی محسوب میشود و محصولی آماده برای استفاده عمومی نیست. سختافزار موردنیاز و زمان اجرای بسیار طولانی نیز این موضوع را تأیید میکند.
در آزمایش انجامشده، دو پردازنده گرافیکی انویدیا B200 به همراه دو پردازنده مرکزی اینتل زئون پلاتینیوم ۸۵۷۰ برای اجرای TufaZip استفاده شدند. فشردهسازی نسخه ۱۰۵.۳۹ مگابایتی به ۶۳۱ هزار و ۵۴۸ ثانیه، معادل حدود ۷.۳ روز زمان نیاز داشت. بازگشایی همین فایل نیز ۶۴۵ هزار و ۷۴۸ ثانیه، یعنی حدود ۷.۵ روز طول کشید. این ارقام شامل زمان آموزش آفلاین مدل اولیه نمیشوند.
نسخه نخست که بهطور کامل به یادگیری آنلاین متکی بود و حجم ۱۰۵.۹۸ مگابایتی داشت، برای فشردهسازی به ۶۴۷ هزار و ۵۹۵ ثانیه و برای بازگشایی به ۶۳۰ هزار و ۱۳۶ ثانیه زمان نیاز داشت.
میزان مصرف حافظه ویدئویی دو پردازنده گرافیکی در این آزمایش به حداکثر ۴۳.۳۷ گیبیبایت رسید. همچنین مجموع مصرف حافظه سیستم، با احتساب حافظه پردازندههای گرافیکی، هنگام فشردهسازی حدود ۶۸ هزار و ۵۲۵ مگابایت و هنگام بازگشایی نزدیک به ۷۳ هزار و ۷۴۸ مگابایت بود.
مقایسه عملکرد TufaZip با برخی دیگر از فشردهسازهای مجموعه enwik9 در بنچمارک Large Text Compression Benchmark به شرح زیر است:
| فشردهساز | حجم نهایی (مگابایت) | سختافزار | زمان فشردهسازی | زمان بازگشایی |
| cmix-neif 2.0 | ۸۹.۳۵ | AMD Epyc 7B13 با ۴ هسته | ۴۹.۲ ساعت | ۴۹.۳ ساعت |
| tufazip v2 | ۱۰۵.۳۹ | دو انویدیا B200 | ۷.۳ روز | ۷.۵ روز |
| DNA-4 | ۱۰۵.۵۵ | انویدیا RTX 4090 | ۱۹.۸ ساعت با احتساب آموزش | ۲.۶ ساعت |
| NNCP v3.2 | ۱۰۷.۲۶ | انویدیا RTX 3090 | ۶۷.۲ ساعت | ۶۶.۳ ساعت |
چرا مدل بزرگتر همیشه نتیجه بهتری ندارد؟
این آزمایش از نظر علمی نکات جالبی درباره تأثیر اندازه مدل و روش پردازش دادهها بر کیفیت فشردهسازی آشکار کرده است. برای مثال، استفاده از واژگان کوچکتر در برخی شرایط نتیجه بهتری به همراه دارد. توکنساز ۴ هزار واژهای عملکرد بهتری نسبت به نسخههای ۸ هزار و ۱۶ هزار واژهای نشان داده است.
اختصاص توکنهای جداگانه به نشانهگذاریهای XML ویکیپدیا نیز برخلاف انتظار، باعث افزایش حجم خروجی شد. اندازه مدل هم همیشه تعیینکننده نیست؛ بهطوریکه مدل ۲۶۷ میلیون پارامتری در این مجموعه داده، اندکی ضعیفتر از مدل ۱۸۸ میلیون پارامتری عمل کرد.
در نسخهای که حجم فایل نهایی آن حدود ۱۰۰ مگابایت بود، افزایش تعداد پارامترها تا حدود ۷۷ میلیون، بهتدریج مزیت خود را از دست داد. در آزمایشی دیگر، استفاده از یک مدل آفلاین بزرگتر با شش لایه، قدرت پیشبینی را افزایش داد و حجم داده فشردهشده را به ۹۹.۱۷ مگابایت رساند. با این حال، وزن بیشتر این مدل باعث شد حجم کلی فایل از نسخهای که صرفا به یادگیری آنلاین متکی بود، بیشتر شود.
بهبود عملکرد فشردهسازی هزینه محاسباتی قابلتوجهی نیز دارد. برای نمونه، افزایش محدوده متن پردازششده قبلی که مدل از آن برای آموزش بیشتر استفاده میکند، از ۱۵ میلیون به ۳۵ میلیون توکن، تنها ۱.۲۱ درصد از حجم فایل نهایی کم کرد؛ اما در مقابل، نیاز محاسباتی را ۴۰ درصد افزایش داد.
نتیجه اصلی این پژوهش نشان میدهد که بهینهسازی مدلهای هوش مصنوعی همیشه با افزایش اندازه یا اختصاص منابع بیشتر امکانپذیر نیست و گاهی هزینه این تغییرات بسیار بیشتر از دستاورد آنها خواهد بود. تامی هی، انتخاب میان کیفیت پیشبینی و اندازه مدل ششلایه را یکی از پرسشهای مهم پژوهشهای بعدی میداند؛ اینکه یک مدل کوچکتر تا چه اندازه میتواند توانایی پیشبینی خود را حفظ کند. در نهایت، نقطه بهینه این فناوری به ایجاد تعادل میان دقت پیشبینی و حجم مدل بستگی خواهد داشت.