

شرکت AMD جزئیات کامل معماری Zen 6 را برای پردازندههای EPYC Venice منتشر کرده است. این معماری با افزایش چشمگیر 27 درصدی IPC، پشتیبانی از حداکثر 256 هسته و قابلیتهای جدید، پلتفرمهای SP7 و SP8 را هدف قرار میدهد. همچنین فناوری FSR 4.1 شرکت AMD برای کارتهای گرافیک سری RX 6000 عرضه شده است.
بررسی ساختار حافظه کش و تفاوت معماریهای Zen 6 و Zen 6C
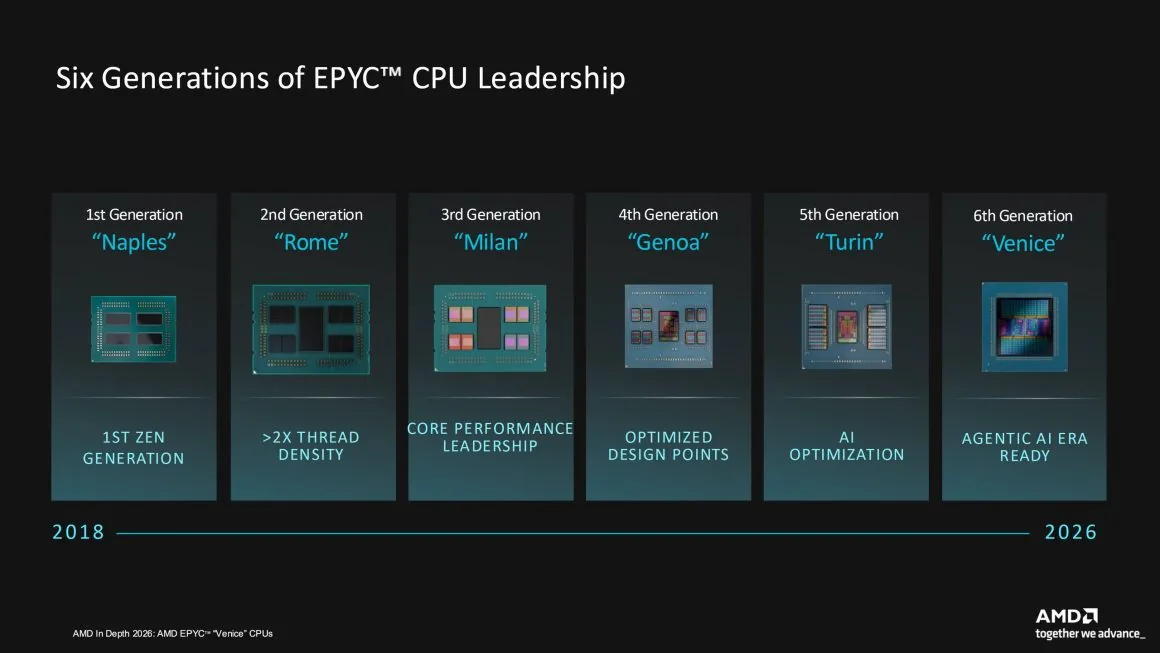
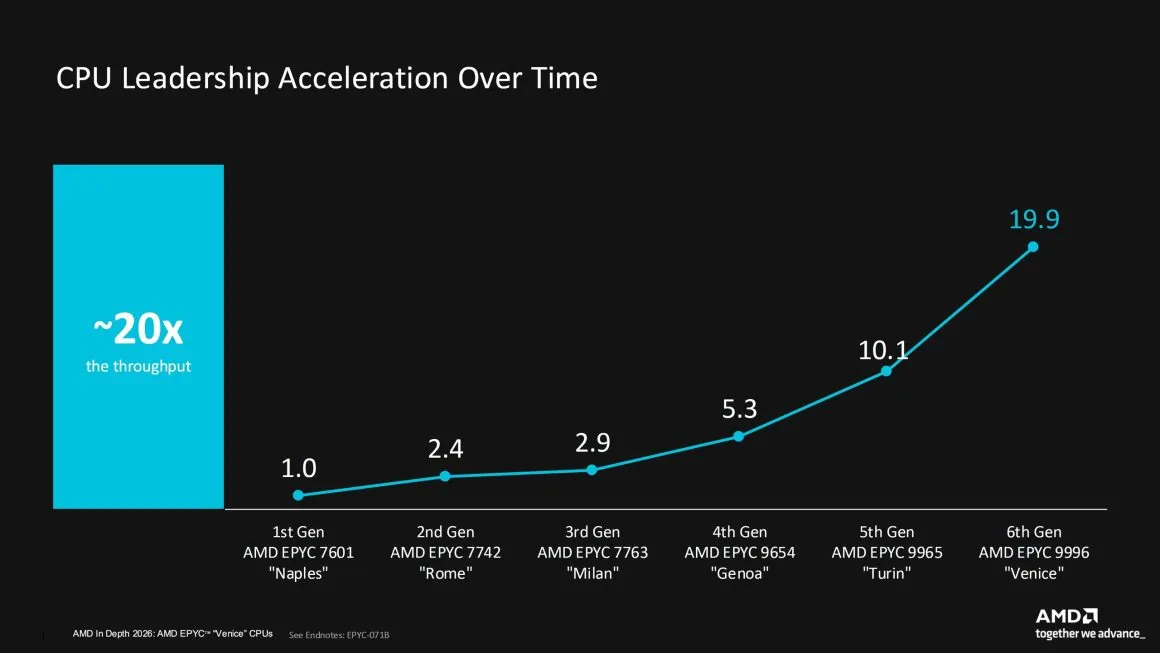
پردازندههای EPYC شرکت AMD تاکنون 6 نسل را پشت سر گذاشتهاند. نخستین نسل این پردازندهها با معماری هسته Zen در سال 2018 با اسم رمز Naples عرضه شد. از آن زمان تاکنون خانواده EPYC با معماریهای جدید هسته، فناوریهای پیشرفته و قابلیتهای متنوع توسعه پیدا کرده است. امروز AMD از عرضه عمومی نسل ششم پردازندههای EPYC با اسم رمز Venice خبر داده است؛ محصولاتی که برای دوران هوش مصنوعی عاملمحور (Agentic AI) طراحی شدهاند.
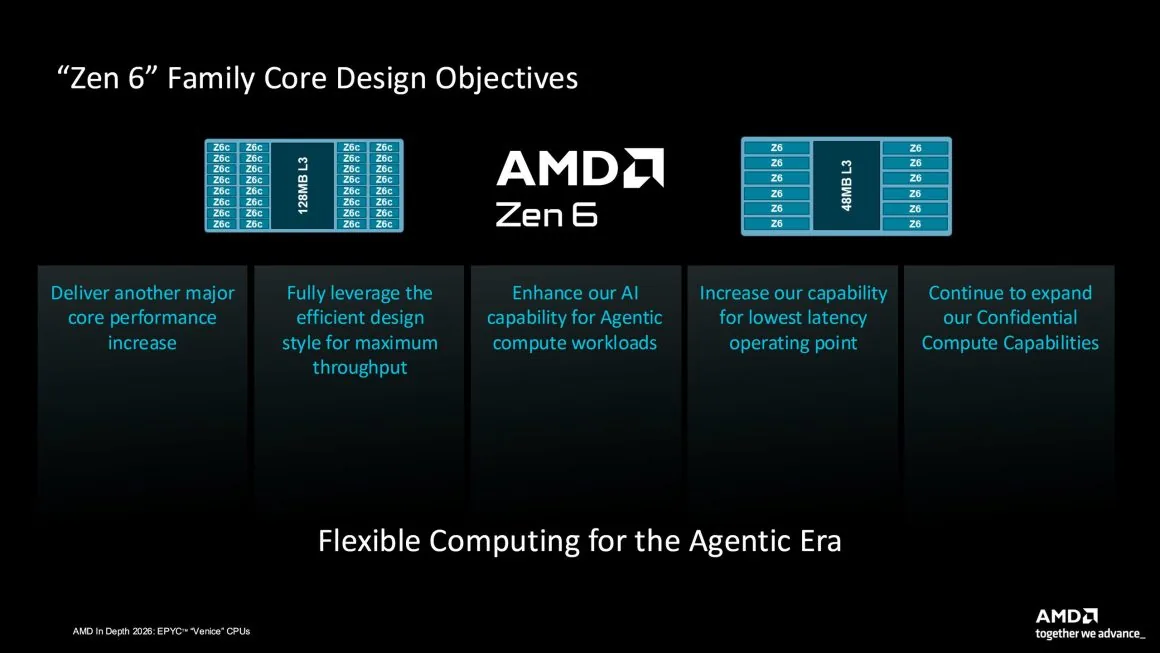
معماریهای هسته Zen 6 و Zen 6C امسال برای نخستین بار با خانواده پردازندههای EPYC 9006 و اسم رمز Venice معرفی شدند. این معماریها جانشین Zen 5 و Zen 5C محسوب میشوند که در خانواده EPYC 9005 با اسم رمز Turin به کار رفته بودند. AMD در معماری Zen 6 تغییرات گستردهای در طراحی ریزمعماری (Microarchitecture) ایجاد کرده تا عملکرد هستهها را افزایش دهد، بهرهوری را بهبود ببخشد، قابلیتهای هوش مصنوعی عاملمحور را توسعه دهد، تاخیر را کاهش دهد و امکانات امنیتی بیشتری ارائه کند.
درست مانند Zen 5 و Zen 5C، معماریهای Zen 6 و Zen 6C نیز از مجموعه دستورالعملهای یکسانی (ISA) استفاده میکنند. Zen 6 نسخه استاندارد هستهها محسوب میشود، درحالیکه Zen 6C نسخه متراکمتر با تراکم هسته بالاتر است. در ادامه ابتدا معماری پایه هسته Zen 6 را بررسی میکنیم.
معماریهای Zen 6 و Zen 6C از 2 بلوک پایه برای بخش واکشی دستورالعمل و خط لوله پردازشی، واحد Dispatch و Rename با پهنای 8 دستورالعمل، تعداد 6 واحد ALU، چهار واحد بارگذاری و 2 واحد ذخیرهسازی، مسیر داده ممیز شناور 512 بیتی، تاخیر 2 سیکل برای دستورالعمل FADD، ظرفیت 64 بایتی برای Fill و Victim و حافظه کش داده 48 کیلوبایتی بهره میبرند.
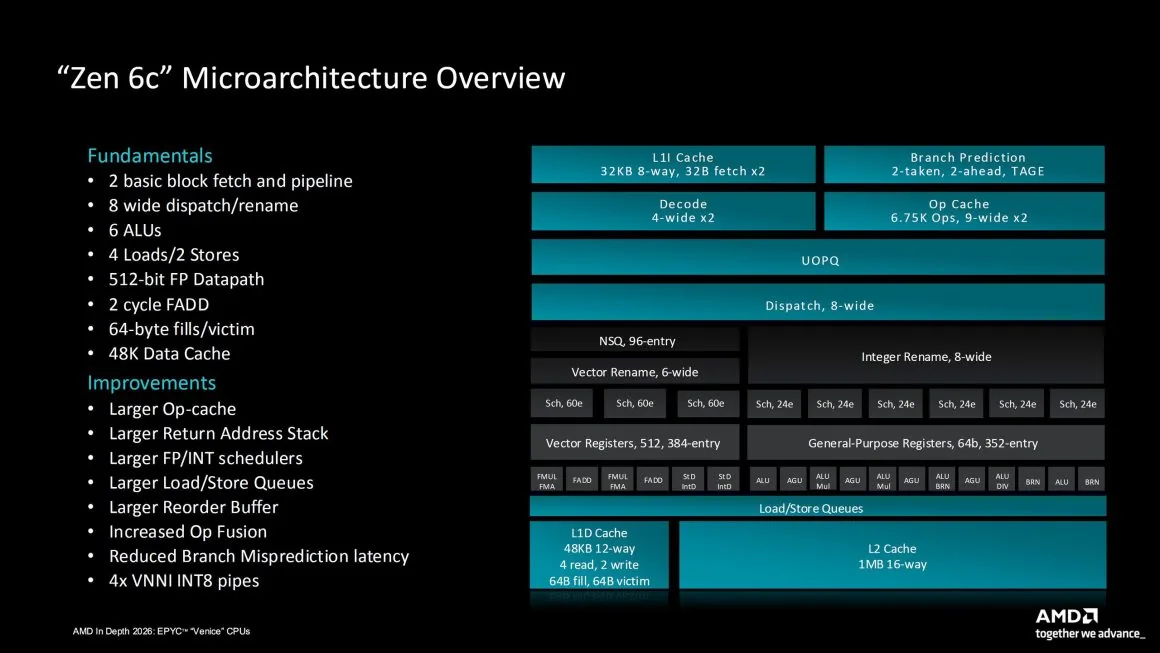
در یک نگاه کلی معماری Zen 6 تغییرات و بهبودهای زیر را ارائه میکند:
- حافظه Op Cache بزرگتر
- پشته آدرس بازگشت (Return Address Stack) بزرگتر
- زمانبندهای ممیز شناور و اعداد صحیح بزرگتر
- صفهای بارگذاری و ذخیرهسازی بزرگتر
- بافر بازترتیب دستورالعملها (Reorder Buffer) بزرگتر
- افزایش قابلیت ادغام دستورالعملها (OP Fusion)
- کاهش تاخیر ناشی از پیشبینی اشتباه انشعابها (Branch Misprediction)
- 4 مسیر پردازشی VNNI INT8
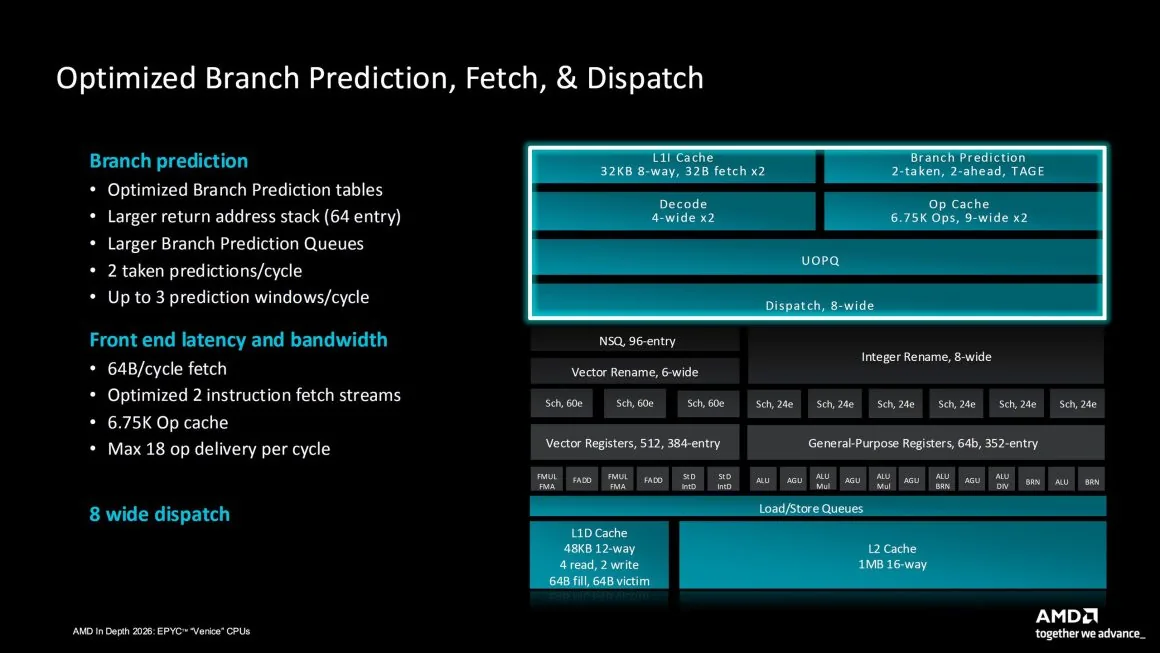
بخش پیشبینی انشعاب (Branch Prediction) از جدولهای بهینهشده، پشته آدرس بازگشت بزرگتر با ظرفیت 64 ورودی، صفهای پیشبینی انشعاب بزرگتر، قابلیت 2 پیشبینی انشعاب گرفتهشده در هر سیکل و حداکثر 3 پنجره پیشبینی در هر سیکل بهره میبرد. بخش Front End نیز به واکشی 64 بایت دستورالعمل در هر سیکل با جریانهای واکشی بهینهشده 2 دستورالعملی، حافظه Op Cache با ظرفیت 6.75 هزار دستورالعمل، حداکثر 18 عملیات قابل تحویل در هر سیکل و واحد Dispatch با پهنای 8 دستورالعمل مجهز شده است. حافظه کش L1I نیز ظرفیت 32 کیلوبایت با ساختار 8-Way دارد.
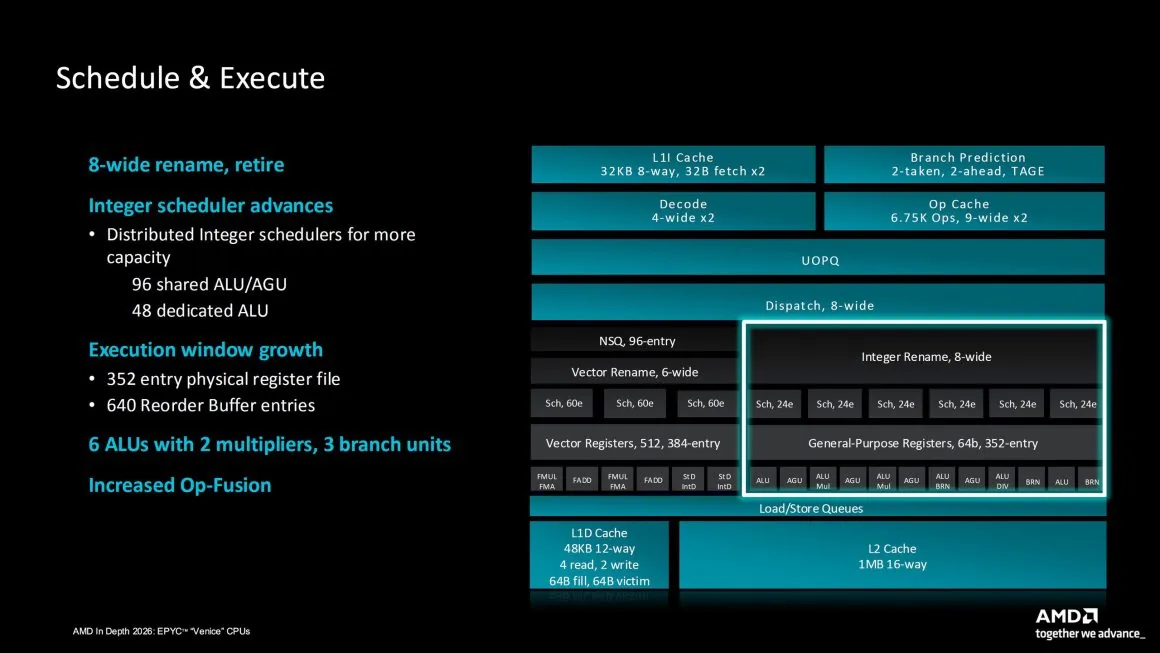
در بخش زمانبندی و اجرا (Schedule and Execute)، معماری جدید از قابلیت Rename و Retire با پهنای 8 دستورالعمل بهره میبرد. ظرفیت پردازشی نیز به لطف زمانبندهای توزیعشده اعداد صحیح افزایش یافته است. این بخش شامل 96 واحد ALU/AGU مشترک و 48 واحد ALU اختصاصی میشود. پنجره اجرای دستورالعملها نیز توسعه یافته و اکنون از فایل رجیستر فیزیکی با 352 ورودی و بافر بازترتیب دستورالعملها با ظرفیت 640 ورودی استفاده میکند. در مجموع هر هسته 6 واحد ALU با 2 ضربکننده، 3 واحد انشعاب و قابلیت ادغام دستورالعملهای بیشتر دارد.
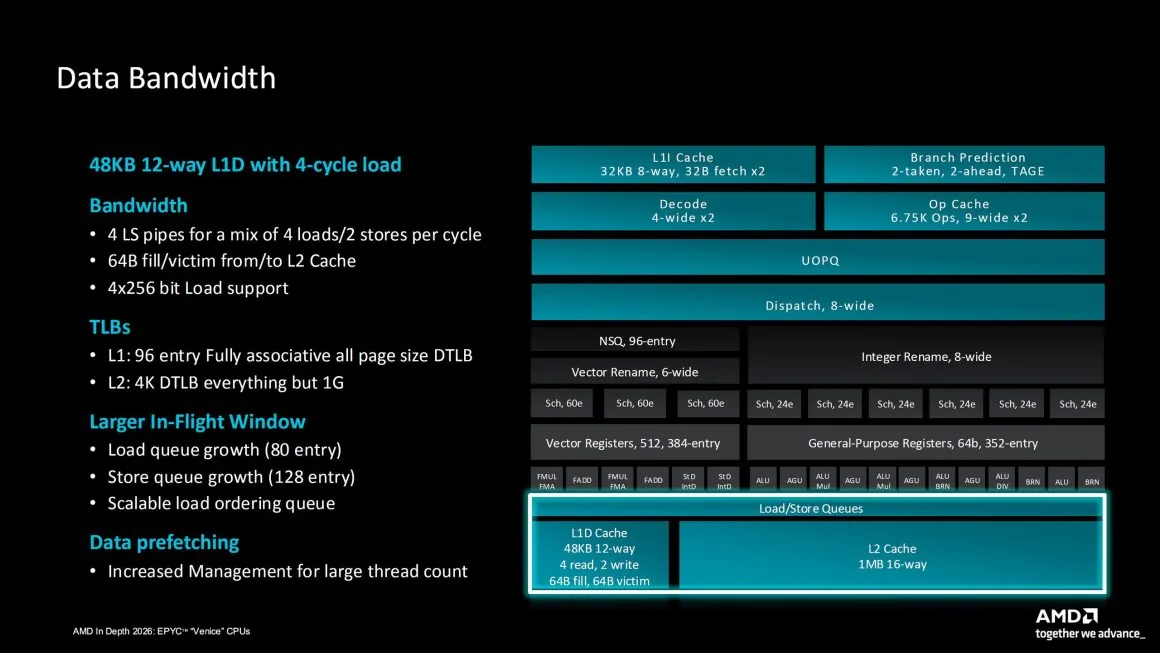
در بخش پهنای باند داده، معماری Zen 6 از حافظه کش L1D با ظرفیت 48 کیلوبایت و ساختار 12-Way بهره میبرد که تأخیر بارگذاری آن 4 سیکل است. پهنای باند نیز با استفاده از 4 مسیر Load/Store افزایش یافته و امکان انجام 4 عملیات بارگذاری و 2 عملیات ذخیرهسازی در هر سیکل فراهم شده است. این معماری از انتقال 64 بایت داده بین حافظههای کش L2 و L1 و همچنین 4 عملیات بارگذاری 256 بیتی پشتیبانی میکند. بخش TLB نیز شامل حافظه L1 با ظرفیت 96 ورودی و حافظه L2 با ظرفیت 4 هزار ورودی برای DTLB است که تمام اندازههای صفحه بهجز 1 گیگابایت را پوشش میدهد. Zen 6 همچنین پنجره پردازش دادههای در حال اجرا را توسعه داده است. ظرفیت صف بارگذاری به 80 ورودی و صف ذخیرهسازی به 128 ورودی افزایش یافته و صف مرتبسازی بارگذاری نیز قابلیت مقیاسپذیری دارد. علاوه بر این هر هسته به 1 مگابایت حافظه کش L2 با ساختار 16-Way مجهز شده است.
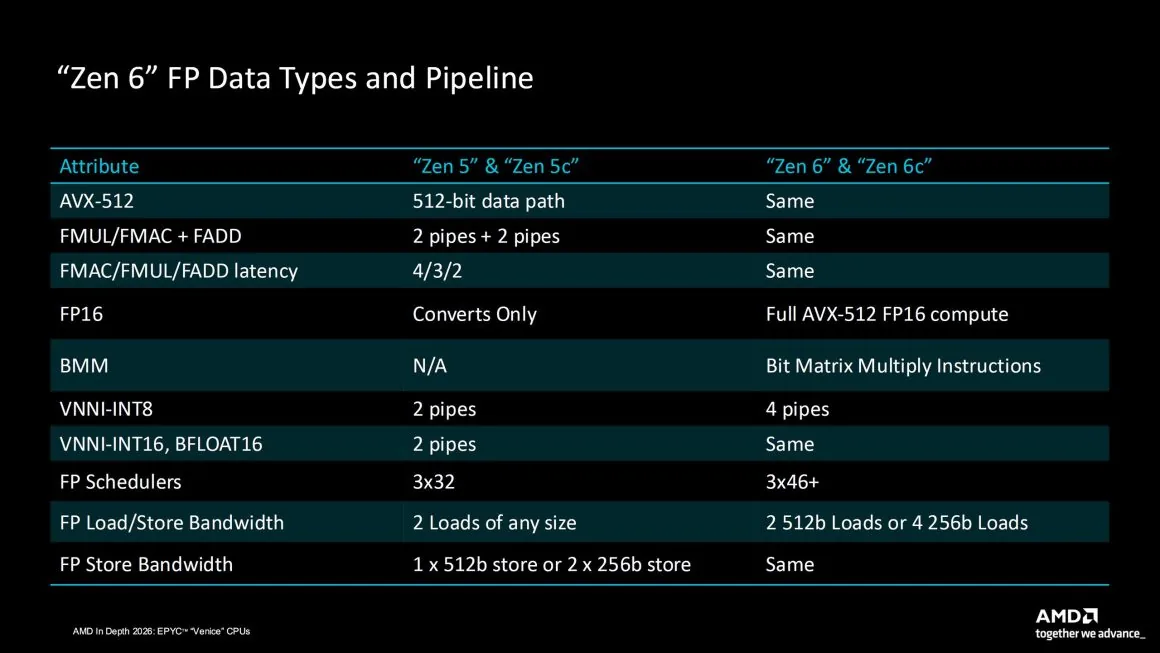
از نظر انواع داده و خط لوله پردازشی، معماریهای Zen 6 و Zen 6C از قابلیتهای یکسانی شامل AVX-512، عملیات FMUL/FMAC+FADD، تاخیر FMAC/FMUL/FADD، دستورالعملهای VNNI-INT16، قالب داده BFLOAT16 و پهنای باند ذخیرهسازی ممیز شناور پشتیبانی میکنند.
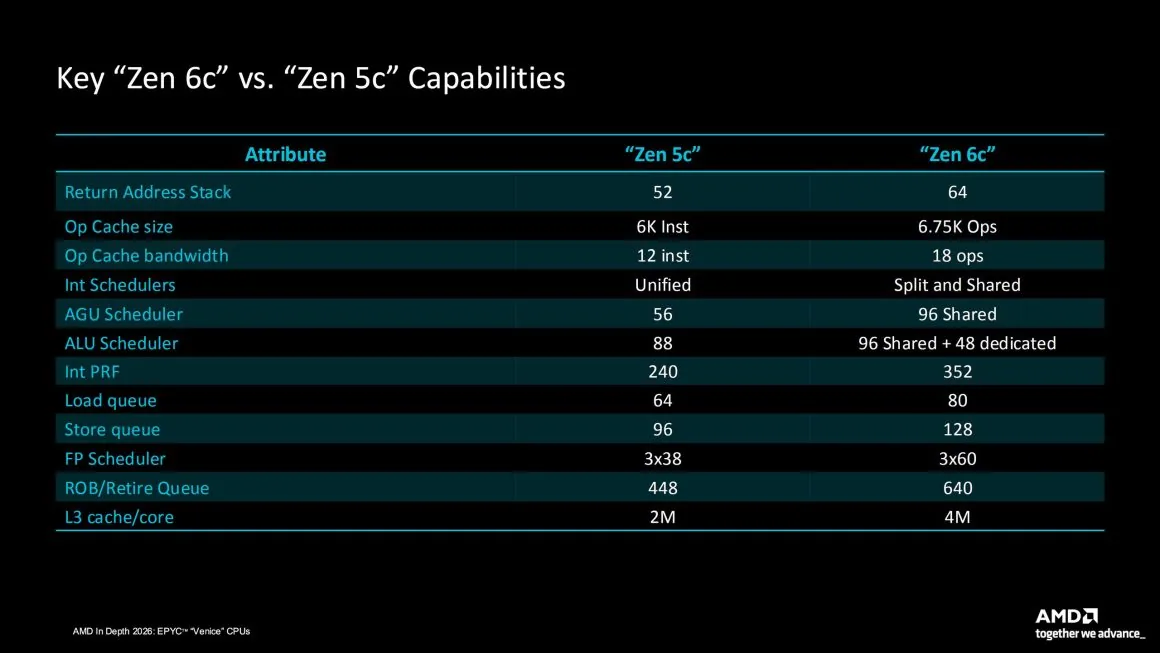
| مشخصه | Zen 5C | Zen 6C | میزان تغییر |
| پشته آدرس بازگشت | 52 | 64 | 23.1 درصد افزایش |
| ظرفیت Op Cache | 6 هزار دستورالعمل | 6.75 هزار عملیات | 12.5 درصد افزایش |
| پهنای باند Op Cache | 12 دستورالعمل | 18 عملیات | 50 درصد افزایش |
| زمانبند اعداد صحیح | یکپارچه | تفکیکشده و مشترک | تغییر معماری |
| زمانبند AGU | 56 | 96 مشترک | 71.4 درصد افزایش |
| زمانبند ALU | 88 | 96 مشترک و 48 اختصاصی | توسعه و بازطراحی |
| فایل رجیستر فیزیکی اعداد صحیح | 240 | 352 | 46.7 درصد افزایش |
| صف بارگذاری | 64 | 80 | 25 درصد افزایش |
| صف ذخیرهسازی | 96 | 128 | 33.3 درصد افزایش |
| زمانبند ممیز شناور | 3×38 | 3×60 | 57.9 درصد افزایش |
| صف ROB/Retire | 448 | 640 | 42.9 درصد افزایش |
| حافظه کش L3 بهازای هر هسته | 2 مگابایت | 4 مگابایت | 100 درصد افزایش |
| اندازه مجتمع پردازشی ابری | 16 هسته | 32 هسته | 100 درصد افزایش |
| مجموع حافظه کش L3 در مجتمع ابری | 32 مگابایت | 128 مگابایت | 300 درصد افزایش |
| حداکثر تعداد هسته در پردازندههای ابری | 192 | 256 | 33.3 درصد افزایش |
یکی از تغییرات مهم به نوع داده FP16 مربوط میشود که اکنون از پردازش کامل AVX-512 FP16 پشتیبانی میکند. همچنین دستورالعملهای Bit Matrix Multiply، تعداد 4 مسیر پردازشی VNNI-INT8 در مقابل 2 مسیر در نسل قبل، سه زمانبند ممیز شناور با حداقل 46 ورودی در مقابل 32 ورودی و قابلیت 2 بارگذاری 512 بیتی یا 4 بارگذاری 256 بیتی در هر سیکل به این معماری اضافه شدهاند. نسل قبلی تنها از 2 عملیات بارگذاری با اندازه دلخواه پشتیبانی میکرد.
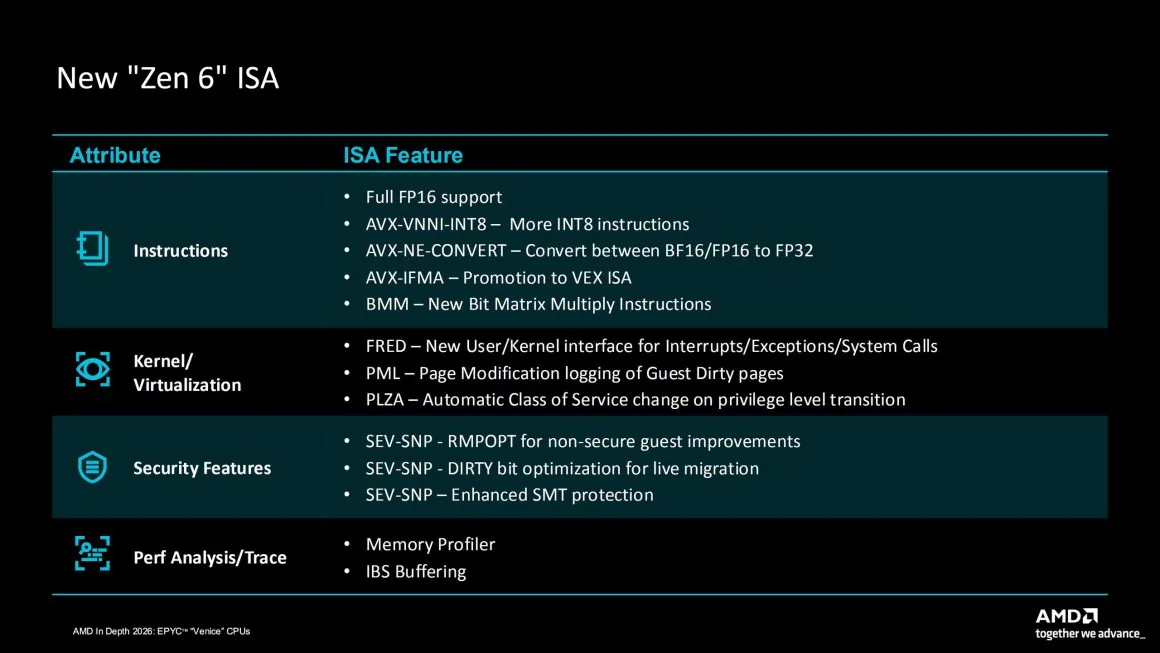
قابلیتهای جدید مجموعه دستورالعملهای Zen 6
هستههای Zen 6 چندین قابلیت کاملاً جدید در مجموعه دستورالعملها (ISA) ارائه میکنند که در جدول زیر مشاهده میکنید:
| دستهبندی | قابلیت جدید |
| دستورالعملها | پشتیبانی کامل از FP16 |
| دستورالعملها | AVX-VNNI-INT8؛ دستورالعملهای بیشتر برای پردازش INT8 |
| دستورالعملها | AVX-NE-CONVERT؛ تبدیل داده بین BF16/FP16 و FP32 |
| دستورالعملها | AVX-IFMA؛ انتقال به مجموعه دستورالعمل VEX |
| دستورالعملها | BMM؛ دستورالعملهای جدید ضرب ماتریسی بیتی |
| کرنل | FRED؛ رابط کاربری و کرنل جدید برای مدیریت وقفهها، استثناها و فراخوانیهای سیستمی |
| کرنل | PML؛ ثبت تغییرات صفحات حافظه مهمان (Guest Dirty Pages) |
| کرنل و مجازیسازی | PLZA؛ تغییر خودکار کلاس سرویس هنگام تغییر سطح دسترسی |
| قابلیتهای امنیتی | SEV-SNP RMPOPT برای بهبود عملکرد ماشینهای مجازی مهمان غیرامن |
| قابلیتهای امنیتی | بهینهسازی بیت DIRTY در SEV-SNP برای انتقال زنده ماشینهای مجازی |
| قابلیتهای امنیتی | محافظت پیشرفته SEV-SNP در برابر حملات مبتنی بر SMT |
| تحلیل عملکرد و ردیابی | Memory Profiler |
| تحلیل عملکرد و ردیابی | IBS Buffering |
ساختار حافظه کش در Zen 6 و Zen 6C
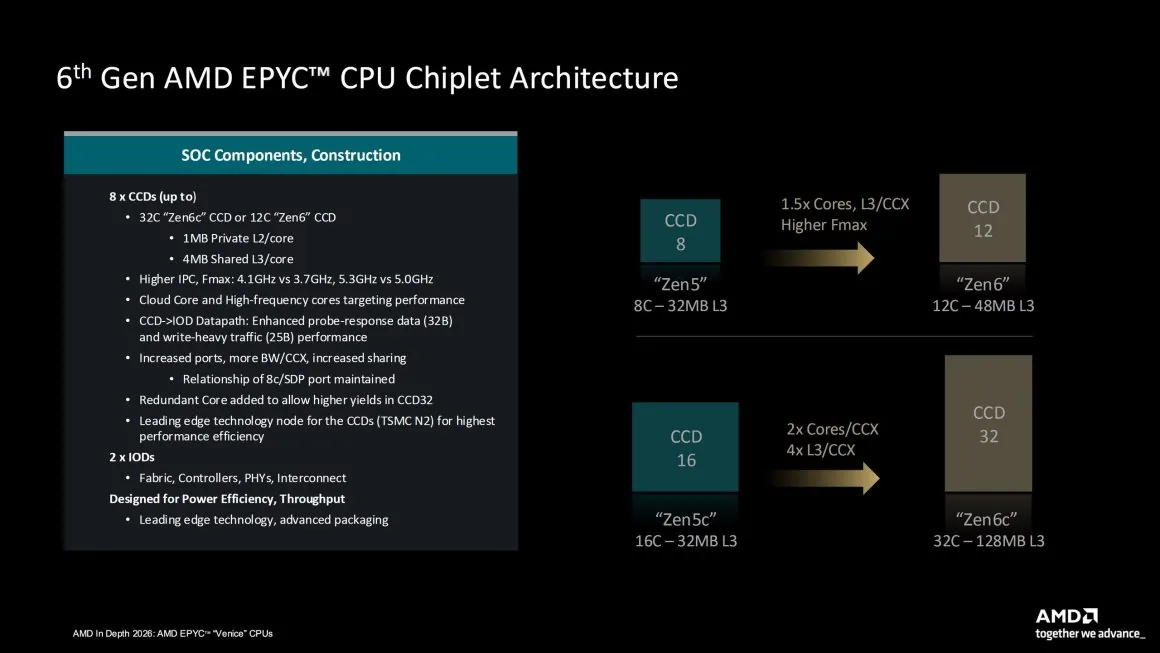
همانند نسل قبلی هستههای Zen 6 و Zen 6C برای بخشهای متفاوتی از بازار طراحی شدهاند. معماری Zen 6 از حداکثر 12 هسته در هر مجتمع پردازشی CCX و حداکثر 48 مگابایت حافظه کش L3 پشتیبانی میکند. در مقابل Zen 6C میتواند حداکثر 32 هسته در هر CCX و 128 مگابایت حافظه کش L3 داشته باشد.
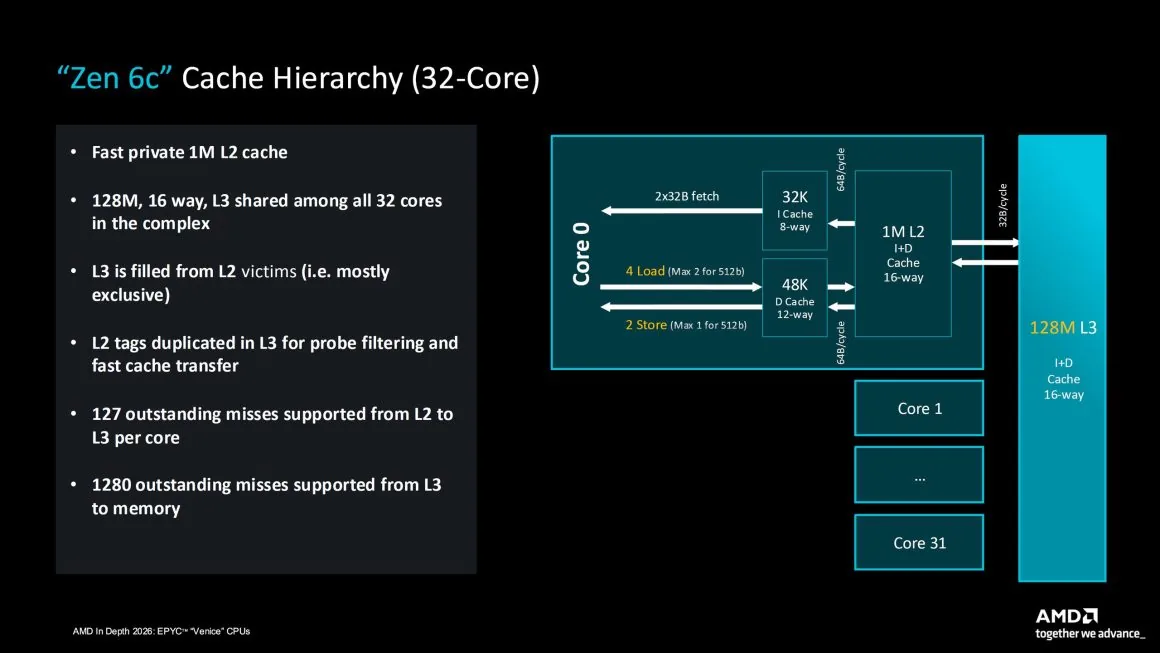
در معماری Zen 6C هر هسته به 1 مگابایت حافظه کش L2 اختصاصی و پرسرعت دسترسی دارد. در مقابل 128 مگابایت حافظه کش L3 با ساختار 16-Way میان تمام 32 هسته موجود در مجتمع پردازشی به اشتراک گذاشته میشود. حافظه کش L3 دادههای جایگزینشده در L2 را دریافت میکند. همچنین تگهای L2 در L3 تکرار میشوند تا فیلتر کردن درخواستهای بررسی حافظه (Probe Filtering) و انتقال سریع داده میان حافظههای کش امکانپذیر باشد. هر هسته از 127 درخواست حافظه در حال انتظار برای انتقال داده از L2 به L3 پشتیبانی میکند. این ظرفیت برای درخواستهای انتقال داده از L3 به حافظه رم سیستم به 1280 درخواست همزمان میرسد.
مشخصات حافظه کش در این معماریها به شرح زیر است:
- Zen 6 L1I: ظرفیت 32 کیلوبایت با ساختار 8-Way
- Zen 6 L1D: ظرفیت 48 کیلوبایت با ساختار 12-Way
- Zen 6 L2: ظرفیت 1 مگابایت با ساختار 16-Way
- Zen 6 L3: ظرفیت 48 مگابایت با ساختار 16-Way
- Zen 6C L3: ظرفیت 128 مگابایت با ساختار 16-Way
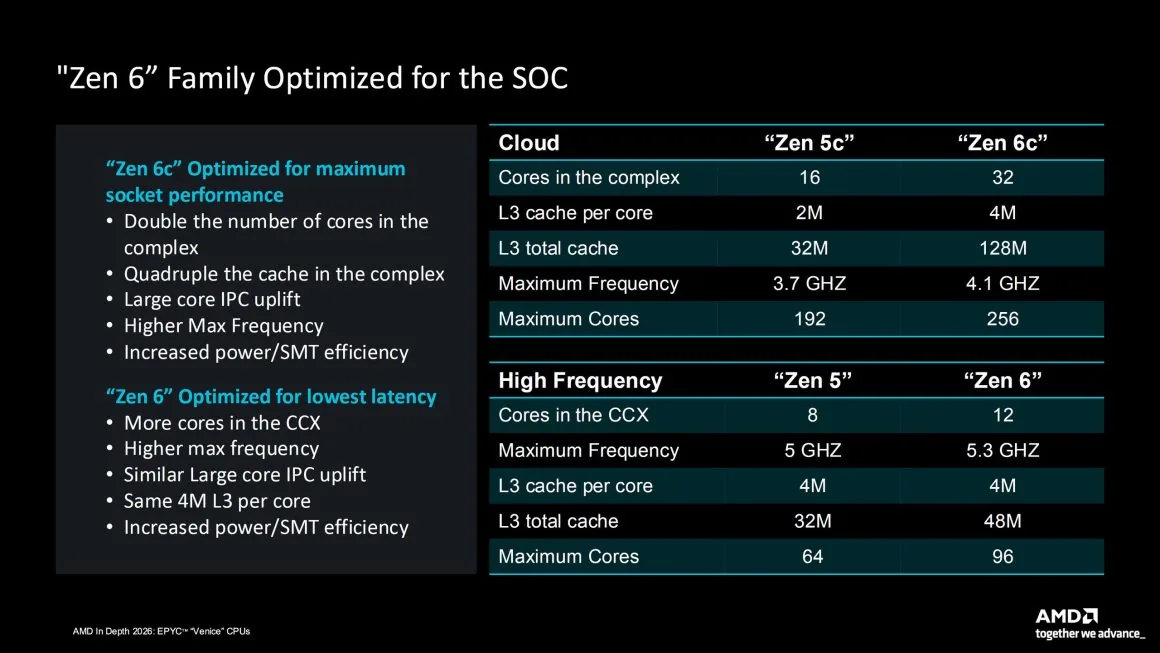
AMD اعلام کرده است که Zen 6 برای دستیابی به حداکثر عملکرد در سطح سوکت بهینهسازی شده درحالیکه Zen 6C کاهش تاخیر را در اولویت قرار میدهد. در مقایسه با Zen 5، معماری Zen 6 تعداد هستههای بیشتر، فرکانس بالاتر، افزایش چشمگیر IPC و بهرهوری بهتر در مصرف انرژی و فناوری SMT را ارائه میکند. جزئیات این تغییرات به شرح زیر است.
معماریهای بهینهشده برای پردازش ابری؛ مقایسه Zen 5C و Zen 6C
| مشخصات پردازندههای ابری | Zen 5C | Zen 6C |
| تعداد هسته در هر مجتمع پردازشی | 16 | 32 |
| حافظه کش L3 بهازای هر هسته | 2 مگابایت | 4 مگابایت |
| مجموع حافظه کش L3 | 32 مگابایت | 128 مگابایت |
| حداکثر فرکانس | 3.7 گیگاهرتز | 4.1 گیگاهرتز |
| حداکثر تعداد هسته | 192 | 256 |
تعداد هستهها و ظرفیت حافظه کش در Zen 6C نسبت به Zen 5C دو برابر شده است. افزایش فرکانس نیز عامل دیگری در بهبود عملکرد محسوب میشود. Zen 6C به لطف استفاده از لیتوگرافی N2P، افزایش فرکانس 400 مگاهرتزی را تجربه میکند. همچنین چهار برابر شدن حافظه کش میتواند بازدهی بیشتری برای دیتاسنترهای ابری به همراه داشته باشد.
معماریهای با فرکانس بالا؛ مقایسه Zen 5 و Zen 6
| مشخصات پردازندههای فرکانس بالا | Zen 5 | Zen 6 |
| تعداد هسته در هر CCX | 8 | 12 |
| حداکثر فرکانس | 5.0 گیگاهرتز | 5.3 گیگاهرتز |
| حافظه کش L3 بهازای هر هسته | 4 مگابایت | 4 مگابایت |
| مجموع حافظه کش L3 | 32 مگابایت | 48 مگابایت |
| حداکثر تعداد هسته | 64 | 96 |
معماری استاندارد Zen 6 تعداد هستهها و رشتههای پردازشی را 50 درصد افزایش میدهد درحالیکه ظرفیت حافظه کش L3 بهازای هر هسته بدون تغییر باقی میماند. مجموع حافظه کش نیز 50 درصد افزایش یافته است. علاوه بر این افزایش 300 مگاهرتزی فرکانس پردازنده نسبت به نسل قبل پیشرفت قابلتوجهی محسوب میشود.
افزایش خیرهکننده 27 درصدی IPC در معماری Zen 6
مجموع این تغییرات باعث شده است معماری Zen 6 بار دیگر افزایش چشمگیری در IPC ارائه کند. AMD برای معماری Zen 6C از افزایش حدود 27 درصدی IPC در پردازشهای هوش مصنوعی و سروری خبر داده است. این رقم در مقایسه با معماری استاندارد Zen 5 به دست آمده است.
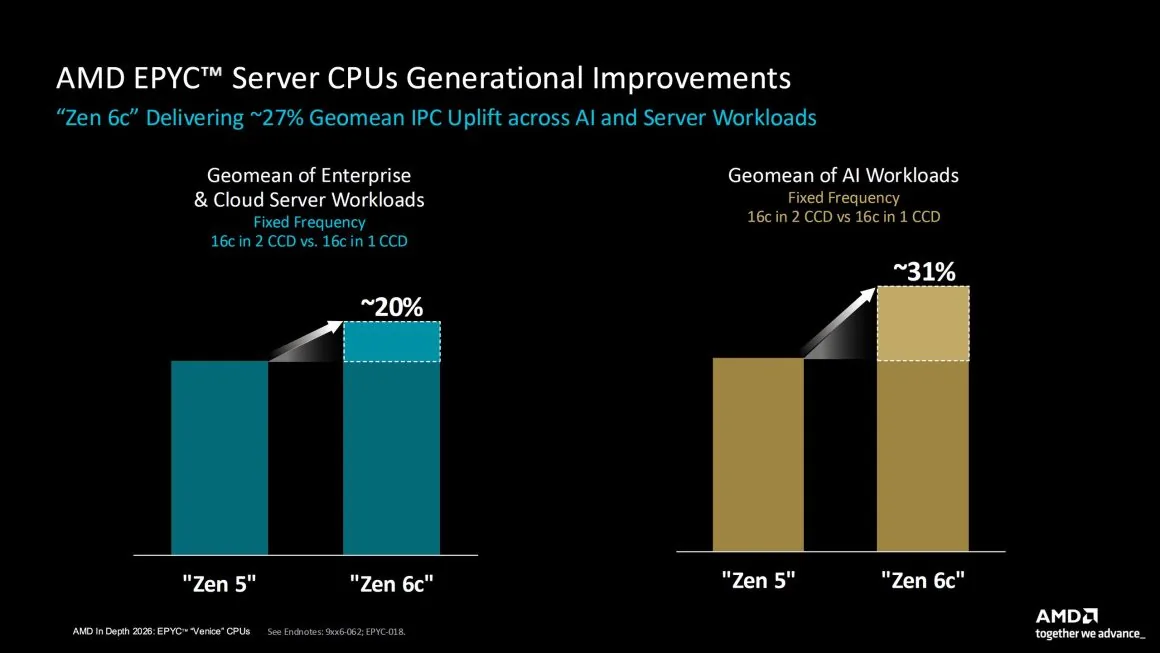
با بررسی دقیقتر نتایج معماری Zen 6C در پردازشهای سازمانی و ابری 20 درصد عملکرد بهتری ارائه میکند. این میزان در پردازشهای هوش مصنوعی به 31 درصد میرسد. AMD برای اندازهگیری IPC، یک پردازنده Zen 5 با 16 هسته در 2 تراشه CCD را با یک پردازنده Zen 6C دارای 16 هسته در یک تراشه CCD مقایسه کرده است. تمام آزمایشها با فرکانس ثابت انجام شدهاند.
مشخصات پردازندههای EPYC Venice و پلتفرم SP7
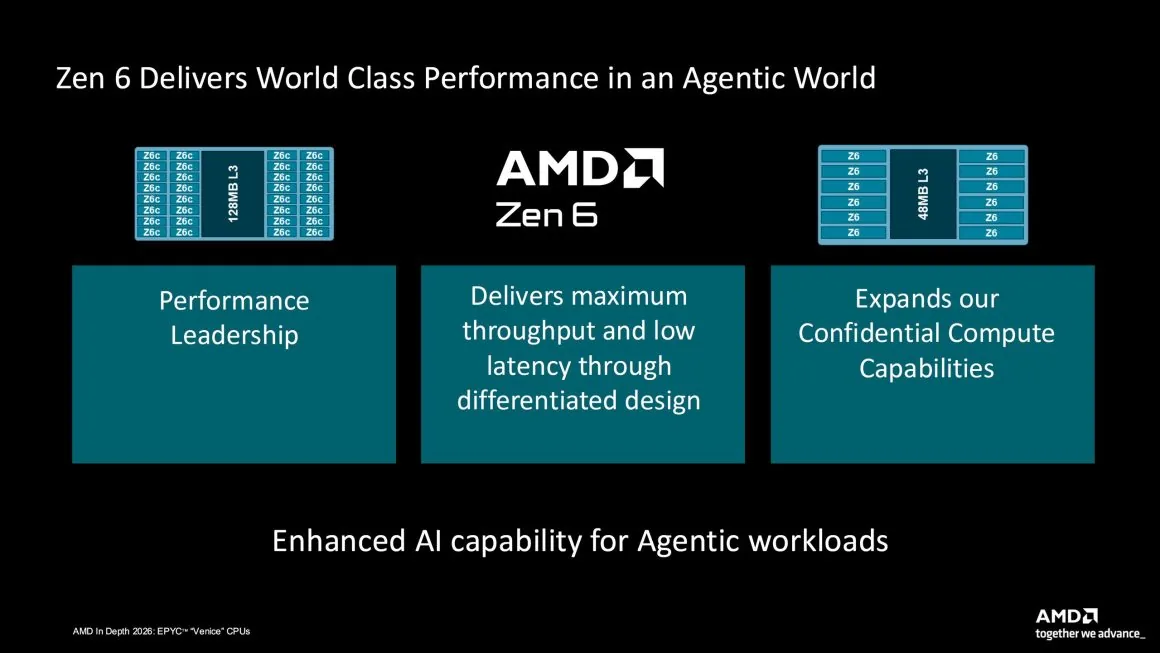
همزمان با عرضه نسل ششم EPYC، شرکت AMD سوکت نسل جدید SP7 را با 2 طراحی متفاوت از سیستم روی تراشه (SoC) معرفی میکند. یکی از این طراحیها بر پایه Zen 6 و دیگری بر اساس Zen 6C توسعه یافته است.
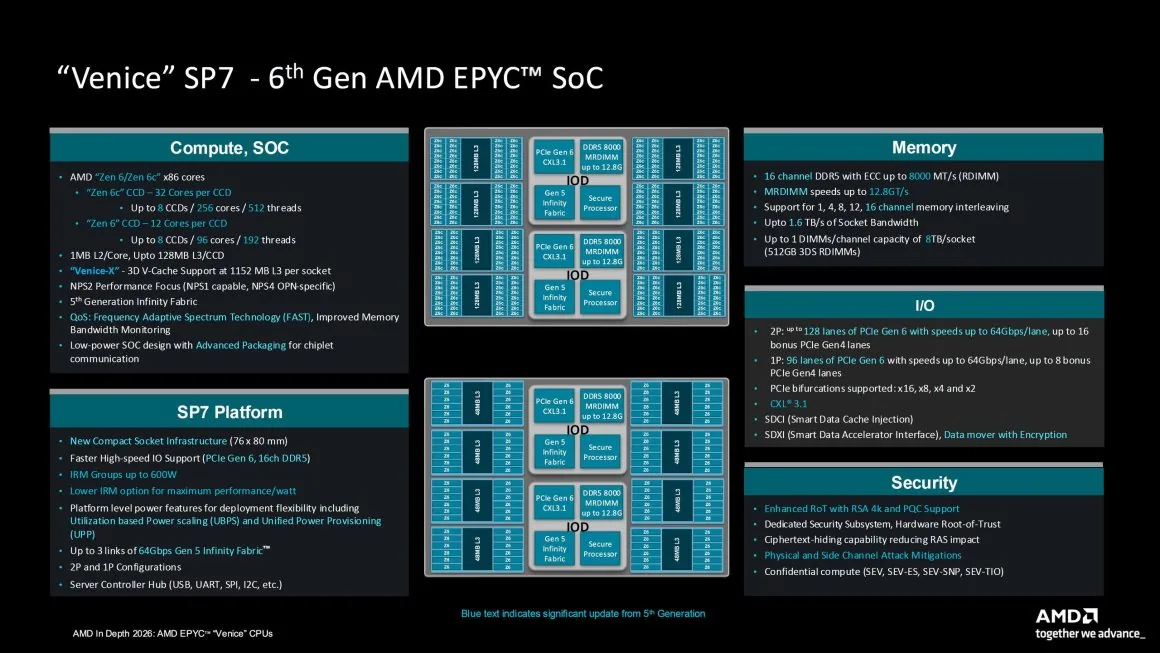
هر 2 طراحی از مجموع 8 تراشه CCD بهره میبرند، اما پیکربندی هستههای آنها تفاوت دارد.
تراشههای CCD مبتنی بر Zen 6C حداکثر 32 هسته و 128 مگابایت حافظه کش دارند. این پیکربندی امکان دستیابی به 256 هسته و مجموع 1024 مگابایت حافظه کش L3 را در هر پردازنده فراهم میکند. در مقابل تراشههای CCD مبتنی بر Zen 6 حداکثر 12 هسته و 48 مگابایت حافظه کش L3 دارند. در نتیجه پردازندههای مبتنی بر این معماری میتوانند حداکثر 96 هسته و 384 مگابایت حافظه کش L3 داشته باشند.
مشخصات این 2 طراحی به شرح زیر است:
- Zen 6 SoC: حداکثر 8 تراشه CCD، حداکثر 12 هسته در هر CCD، مجموعاً 96 هسته در هر پردازنده، 48 مگابایت حافظه کش L3 در هر CCD و حداکثر 384 مگابایت حافظه کش L3 در هر پردازنده
- Zen 6C SoC: حداکثر 8 تراشه CCD، حداکثر 32 هسته در هر CCD، مجموعاً 256 هسته در هر پردازنده، 128 مگابایت حافظه کش L3 در هر CCD و حداکثر 1024 مگابایت حافظه کش L3 در هر پردازنده
هر هسته در مجموع 1 مگابایت حافظه کش L2 دارد. به همین دلیل پردازندههای Zen 6 مجموعاً 96 مگابایت و مدلهای Zen 6C در مجموع 256 مگابایت حافظه کش L2 ارائه میکنند. این پردازندهها با تمرکز بر عملکرد NUMA در سطح هر SoC طراحی شدهاند و از پیکربندی NPS1 پشتیبانی میکنند. پیکربندی NPS4 نیز به مدلهای خاص OPN محدود میشود. هر پردازنده از فناوری ارتباطی نسل پنجم Infinity Fabric بهره میبرد. طراحی کممصرف SoC نیز با بستهبندی پیشرفته تراشهها همراه شده تا ارتباط میان چیپلتها با سرعت بیشتری انجام شود.
قابلیتهای ارتباطی و ورودی و خروجی
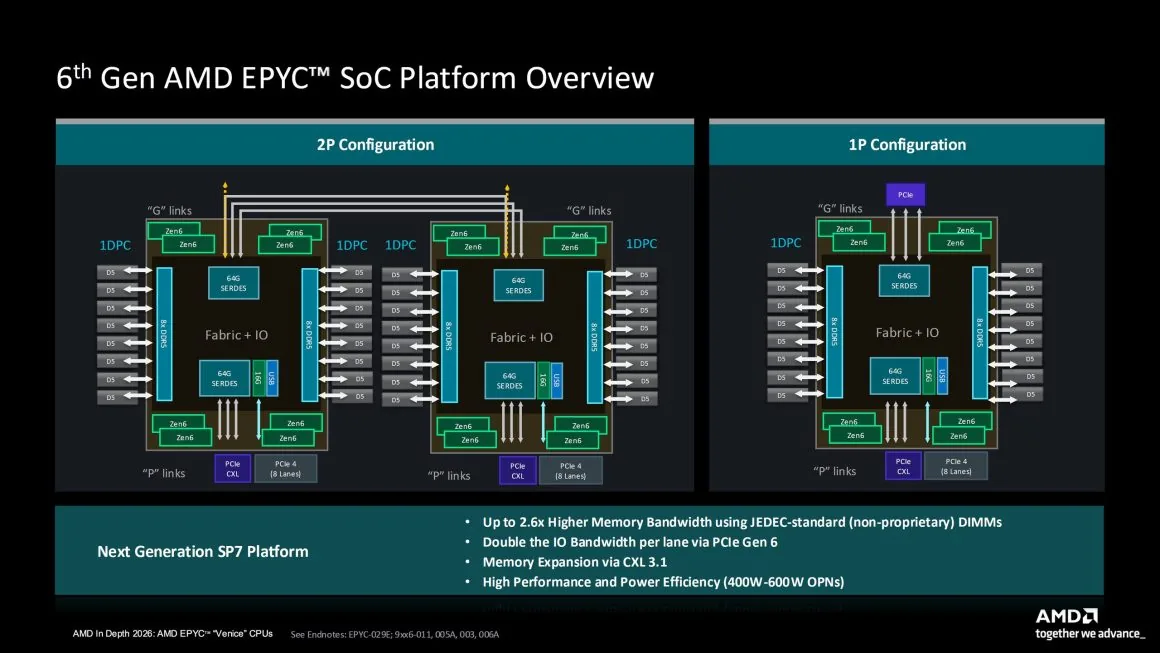
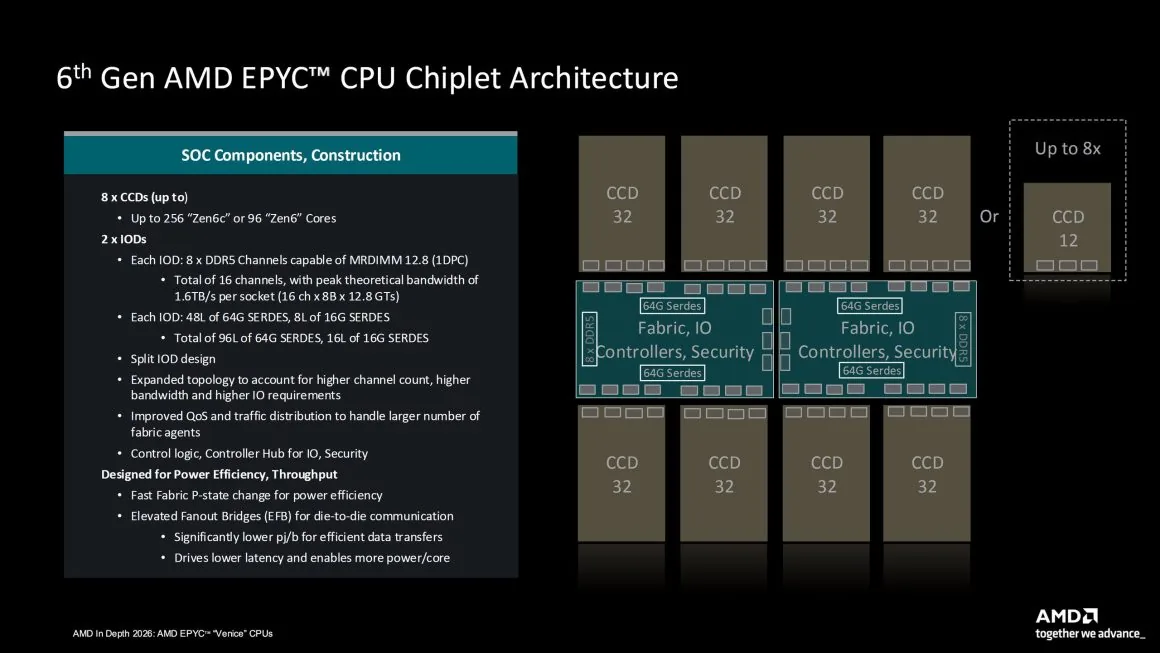
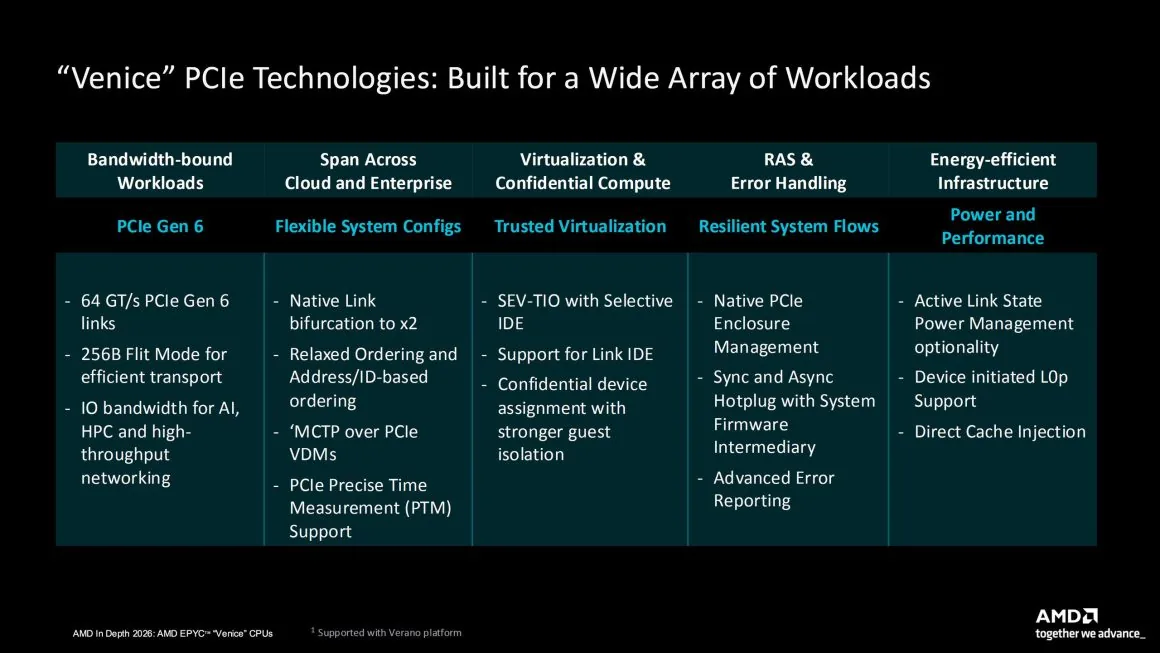
AMD از 2 دای ورودی و خروجی بزرگ (IOD) مبتنی بر فناوری ساخت N3 استفاده میکند. این بخشها در پیکربندی 2P از حداکثر 128 مسیر PCIe Gen6 با سرعت 64 گیگابیت بر ثانیه برای هر مسیر و 16 مسیر اضافه PCIe Gen4 پشتیبانی میکنند. در پیکربندیهای 1P نیز 96 مسیر PCIe Gen6 به همراه 8 مسیر اضافه PCIe Gen4 در اختیار قرار میگیرد. IOD از تقسیمبندی مسیرهای PCIe در اندازههای x16، x8، x4 و x2 پشتیبانی میکند. همچنین رابط SDCI با نام Smart Data Cache Injection و رابط SDXI با نام Smart Data Accelerator Interface در این بخش قرار دارند.
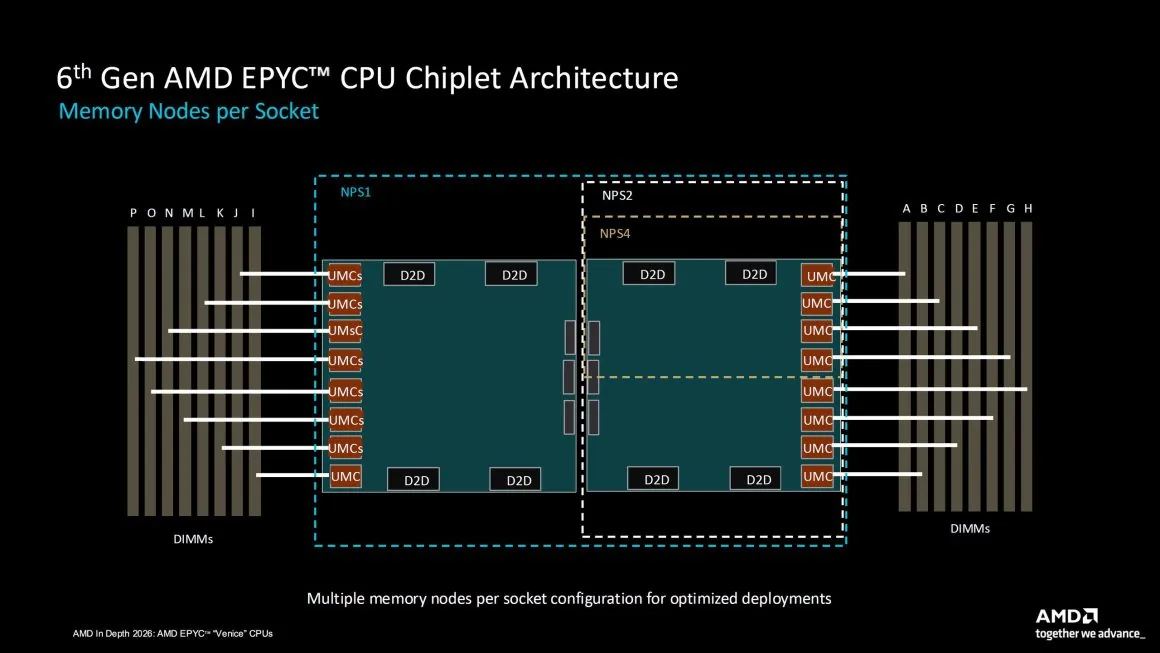
هر IOD از 8 کانال حافظه DDR5 پشتیبانی میکند که امکان استفاده از ماژولهای MRDIMM با سرعت حداکثر 12.8 GT/s را در پیکربندی 1DPC فراهم میسازند. هر IOD همچنین به 48 مسیر SerDes با سرعت 64 گیگابیت و 8 مسیر SerDes با سرعت 16 گیگابیت مجهز شده است. طراحی دوگانه ورودی و خروجی به AMD اجازه میدهد ساختار ارتباطی پلتفرم را برای پشتیبانی از تعداد کانالهای بیشتر، پهنای باند بالاتر و نیازهای گستردهتر ورودی و خروجی توسعه دهد. این تغییرات در کنار بهبود کیفیت سرویس (QoS)، توزیع ترافیک، منطق کنترلی و هاب کنترلر ورودی و خروجی و امنیت قرار میگیرند.
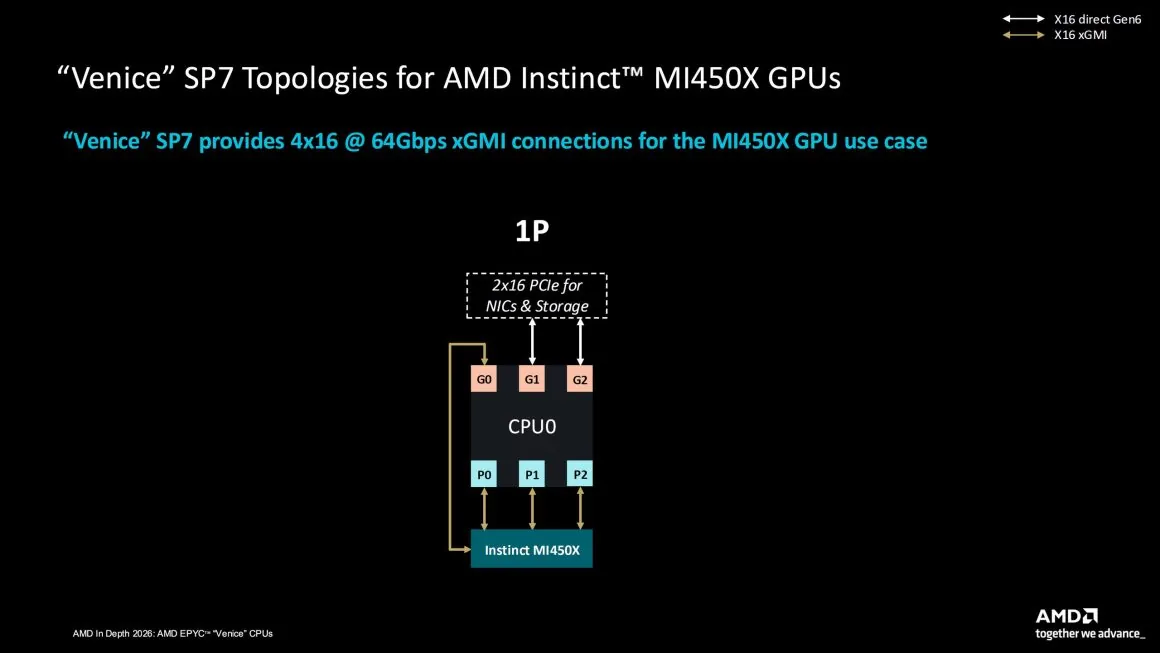
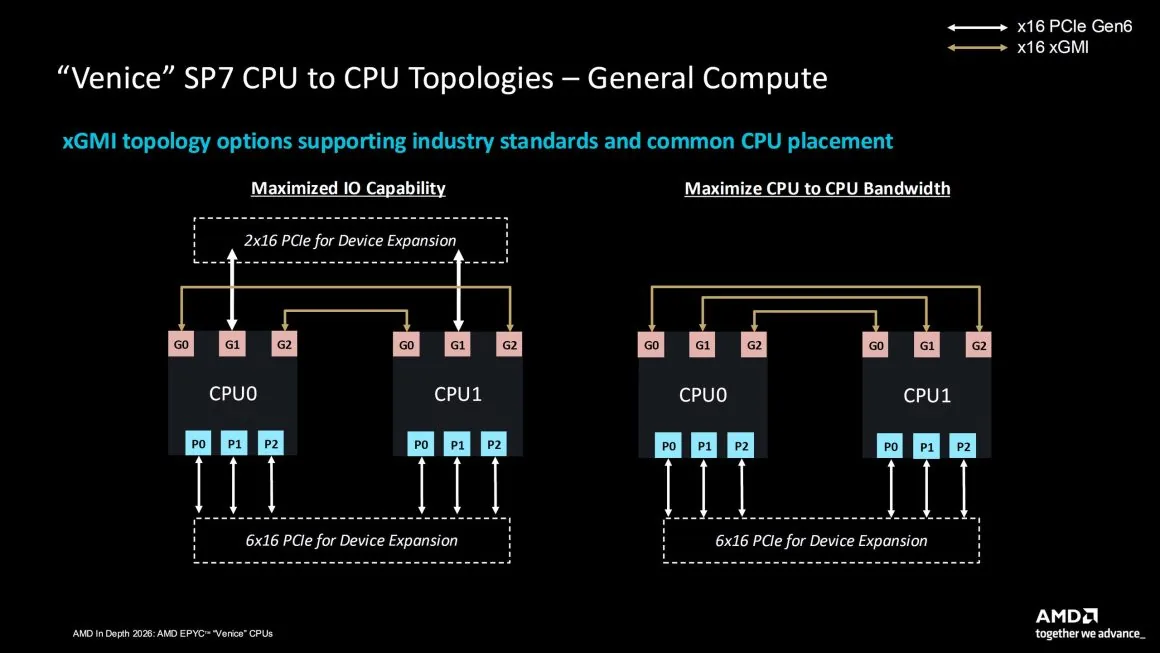
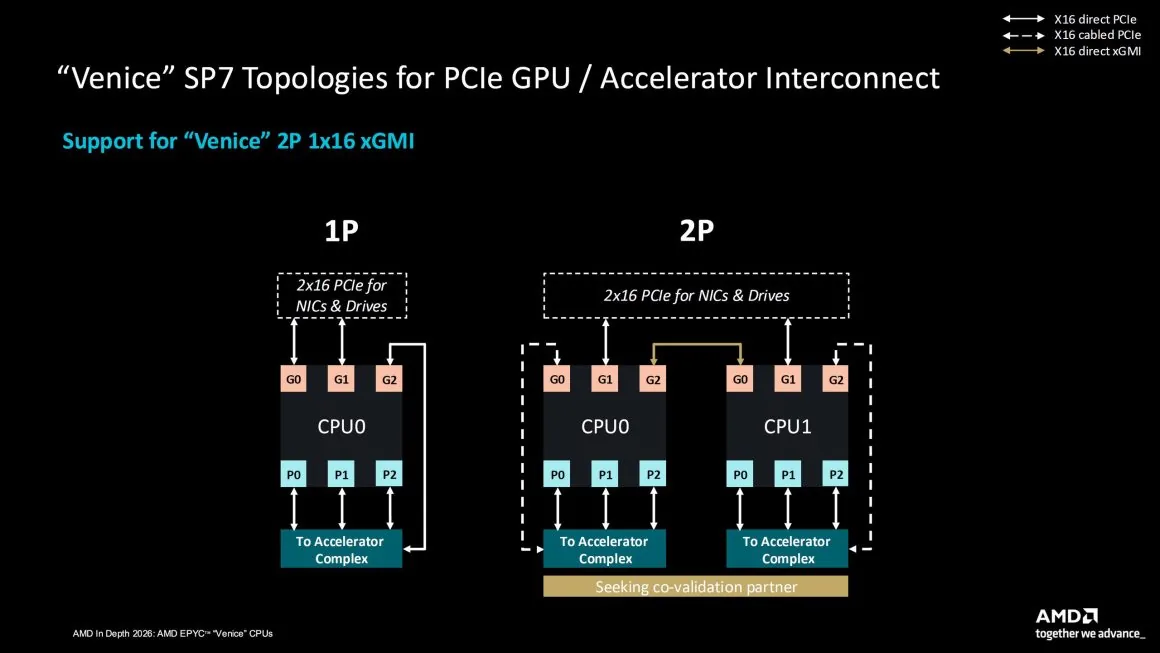
AMD همچنین معماری چیپلت خود را برای دستیابی به توان عملیاتی بالاتر و بهرهوری بهتر توسعه داده است. این شرکت از تغییر سریع وضعیت P-State در Infinity Fabric و پلهای Elevated Fan-Out یا EFB برای ارتباط میان دایها استفاده میکند. فناوری EFB مصرف انرژی بهازای هر بیت را به میزان قابلتوجهی کاهش میدهد. این فناوری در کنار کاهش تاخیر امکان تخصیص توان بیشتری به هر هسته را فراهم میکند.
محدوده مصرف انرژی و عملکرد پردازندههای Zen 6 و Zen 6C
AMD معماری Zen 6 را در محدودههای مختلف مصرف انرژی بهینهسازی کرده تا حداکثر عملکرد، عملکرد بهازای هر وات، عملکرد بهازای هر هسته و هزینه کل مالکیت (TCO) بهبود پیدا کنند. در پردازشهای هوش مصنوعی عاملمحور توان پیشفرض پردازنده تا 400 وات تنظیم میشود. نرخ استفاده از پردازنده در این شرایط بین 50 تا 100 درصد قرار دارد. هر هسته نیز بین 1.2 تا 2 وات مصرف میکند؛ زیرا تمرکز اصلی بر تراکم پردازشی، عملکرد بهازای هر وات و تعداد رشتههای پردازشی بهازای هر مگاوات است.
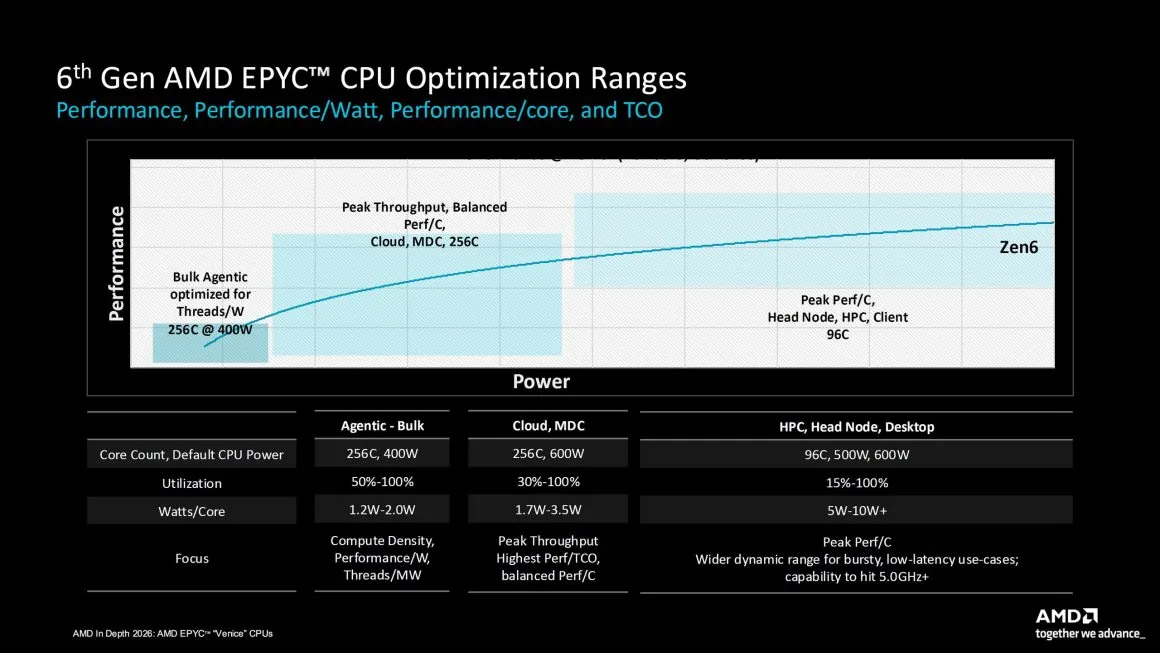
در پردازشهای ابری و MDC، هسته Zen 6 شرکت AMD برای دستیابی به حداکثر توان عملیاتی و ایجاد تعادل میان عملکرد هستهها بهینه شده است. در این شرایط، حداکثر توان پیشفرض به 600 وات میرسد. نرخ استفاده از پردازنده بین 30 تا 100 درصد قرار دارد و هر هسته حدود 1.7 تا 3.5 وات مصرف میکند. این پیکربندی بالاترین نسبت عملکرد به هزینه کل مالکیت (Perf/TCO) را در کنار تعادل مناسب عملکرد هستهها ارائه میدهد.
AMD برای پردازشهای هوش مصنوعی عاملمحور و ابری از پردازندههای مجهز به 256 هسته Zen 6C استفاده میکند. در مقابل برای پردازندههای Head Node با اسم رمز Helion، پردازشهای HPC و بخش کامپیوترهای دسکتاپ معماری استاندارد Zen 6 به کار گرفته میشود.
در این دسته از محصولات، توان پیشفرض پردازنده بین 500 تا 600 وات قرار دارد. نرخ استفاده از هر هسته بین 15 تا 100 درصد متغیر است و توان مصرفی هر هسته به 5 تا بیش از 10 وات میرسد. این طراحی به Zen 6 اجازه میدهد در طیف گستردهتری از شرایط پردازشی، از وظایف ناگهانی با تاخیر پایین گرفته تا پردازشهای سنگین عملکرد مناسبی ارائه دهد. همچنین فرکانس هستهها میتواند از 5 گیگاهرتز فراتر برود.
معرفی سوکت SP8؛ پلتفرم جدید AMD برای پردازندههای EPYC
AMD در کنار سوکت SP7، سوکت جدید SP8 را نیز معرفی کرده است که برای پیکربندیهای 2P و 1P بهینهسازی شده است. در این پلتفرم مدلهای مبتنی بر Zen 6C از 4 تراشه CCD بهره میبرند و حداکثر 128 هسته و 256 رشته پردازشی به همراه 512 مگابایت حافظه کش ارائه میکنند. نسخه استاندارد Zen 6 نیز به 8 تراشه CCD مجهز میشود و مجموعاً 96 هسته، 192 رشته پردازشی و 384 مگابایت حافظه کش L3 دارد.
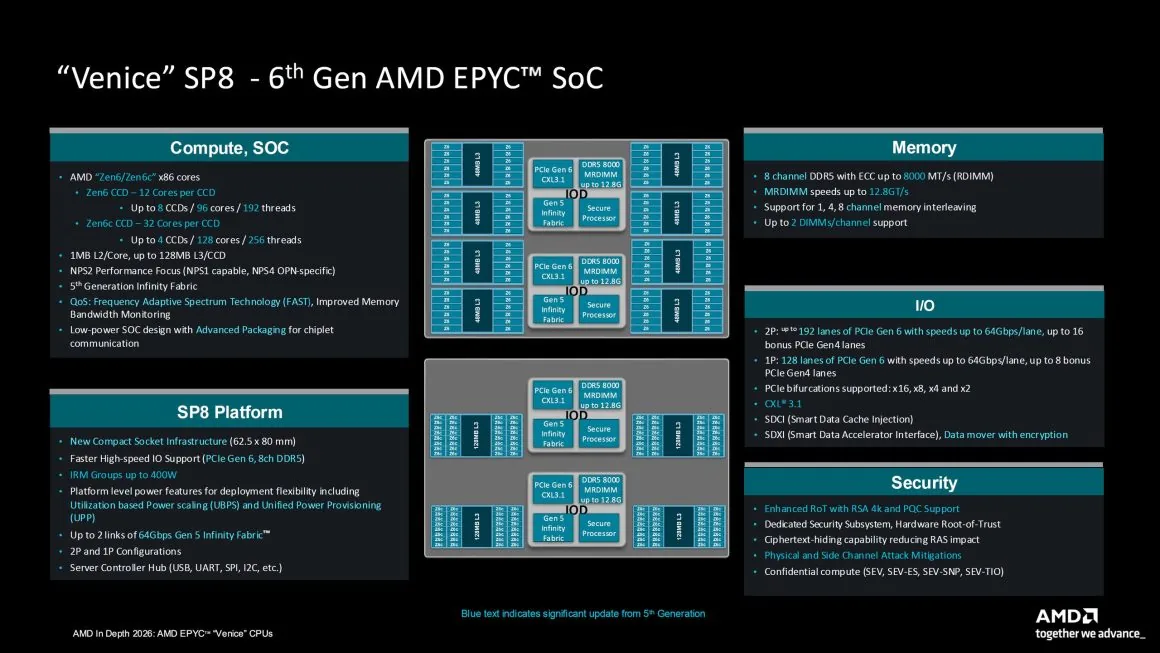
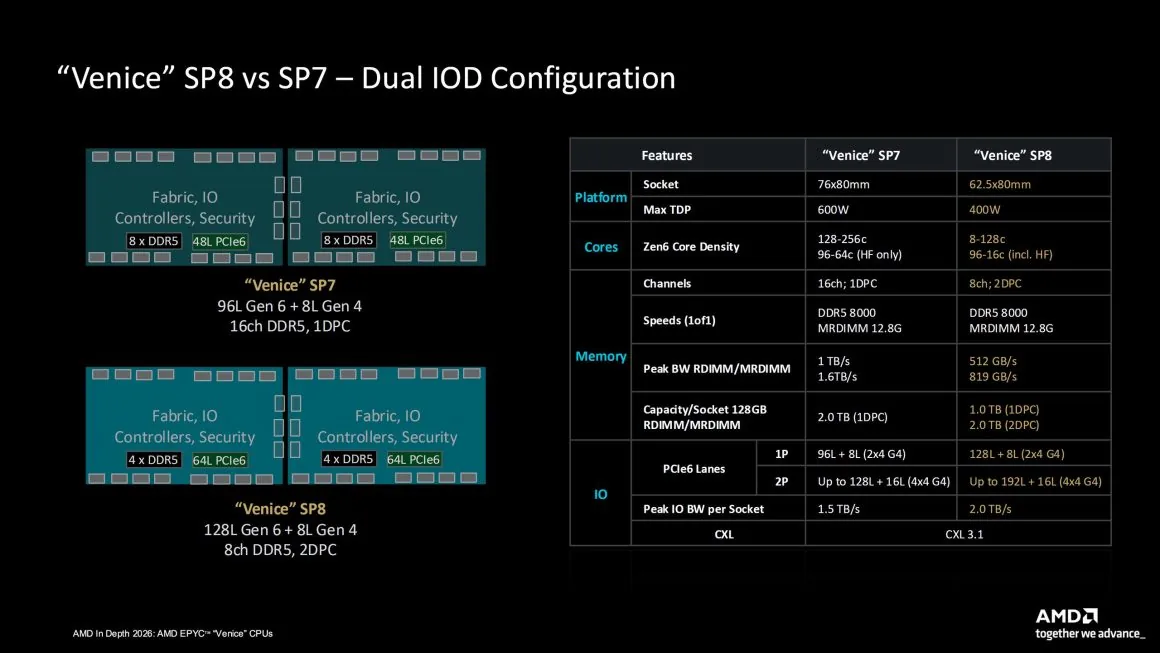
در سطح پلتفرم سوکت SP8 از طراحی فشردهای با ابعاد 62.5 در 80 میلیمتر استفاده میکند. این پلتفرم از حافظه DDR5 با 8 کانال پشتیبانی میکند؛ درحالیکه SP7 به 16 کانال مجهز شده است. با وجود کاهش تعداد کانالها پشتیبانی از حافظه MRDIMM با سرعت حداکثر 12.8 GT/s در هر 2 پلتفرم حفظ میشود.
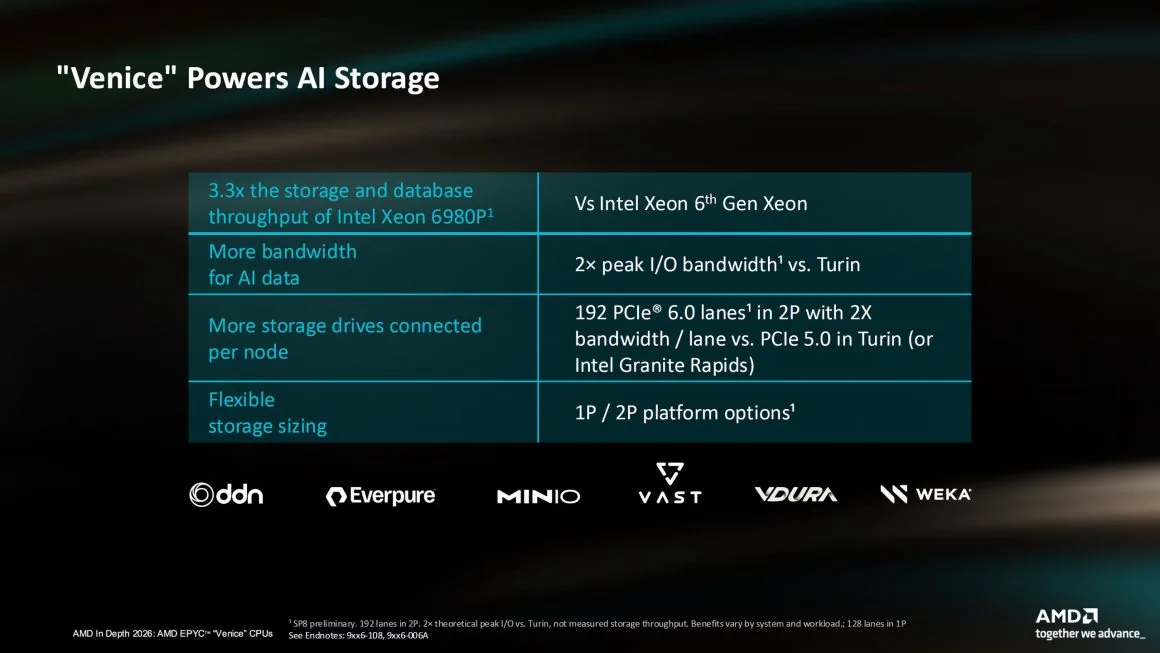
از نظر ارتباطات ورودی و خروجی، پیکربندیهای 2P در پلتفرم SP8 حداکثر 192 مسیر Gen6 و 16 مسیر اضافه Gen4 ارائه میکنند. این ارقام در پیکربندیهای 1P به 128 مسیر Gen6 و 8 مسیر اضافه Gen4 میرسند. پشتیبانی از استاندارد CXL 3.1 نیز در این پلتفرم وجود دارد.
پلتفرمهای SP7 از پردازندههایی با توان حداکثر 600 وات و SKUهای اختصاصی OPN پشتیبانی میکنند. در مقابل حداکثر توان پردازندههای سازگار با SP8 به 400 وات محدود میشود. پهنای باند اوج حافظه در پلتفرم SP8 با استفاده از RDIMM به 512 گیگابایت بر ثانیه میرسد؛ درحالیکه این رقم در SP7 برابر با 1 ترابایت بر ثانیه است. با استفاده از MRDIMM نیز پهنای باند SP8 به 819 گیگابایت بر ثانیه میرسد. این رقم در SP7 برابر با 1.6 ترابایت بر ثانیه است. با این حال پهنای باند اوج ورودی و خروجی بهازای هر سوکت در SP8 بیشتر است و به 2 ترابایت بر ثانیه میرسد؛ درحالیکه این مقدار در SP7 برابر با 1.5 ترابایت بر ثانیه است.
پشتیبانی از نسل جدید حافظههای DDR5 MRDIMM و فناوری CXL 3.1
حافظه بهاندازه خود پردازنده اهمیت دارد. به همین دلیل پلتفرمهای SP7 و SP8 شرکت AMD از مجموعه گستردهای از فناوریهای حافظه پشتیبانی میکنند که شامل DDR5 MRDIMM Gen2، حافظه DDR5 RDIMM، حافظه LPDDR5X SOCAMM2، استاندارد CXL 3.1 و فناوری MEXT میشود. AMD اعلام کرده است که جزئیات کاربردهای LPDDR5X و MEXT را در مقالههای جداگانه منتشر خواهد کرد.
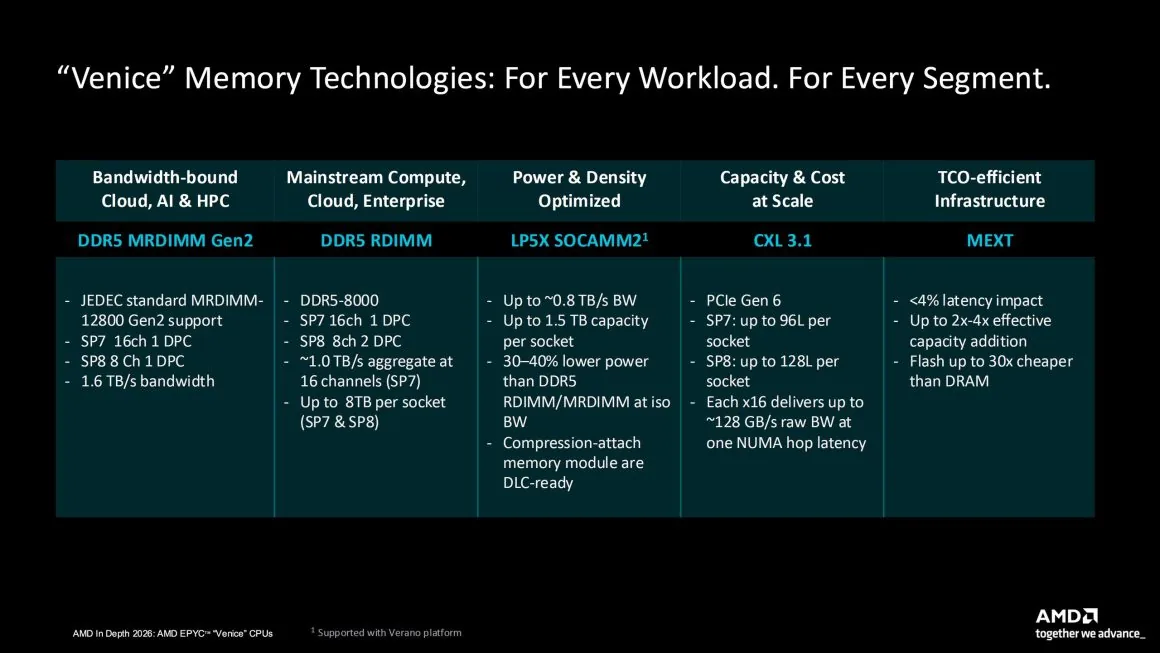
در ابتدا به حافظه DDR5 MRDIMM Gen2 میپردازیم. پردازندههای EPYC Venice در پلتفرم SP7 از 16 کانال حافظه با پیکربندی 1DPC و در SP8 از 8 کانال حافظه با همین پیکربندی پشتیبانی میکنند. حداکثر سرعت این حافظهها به 12,800 MT/s میرسد. استاندارد جدید حافظه MRDIMM امکان دستیابی به پهنای باند حداکثر 1.6 ترابایت بر ثانیه را فراهم میکند.
حافظههای استاندارد DDR5 RDIMM نیز با سرعت حداکثر 8000 MT/s در پلتفرم EPYC Venice پشتیبانی میشوند. این حافظهها در مجموع 16 کانال، پهنای باند حداکثر 1 ترابایت بر ثانیه ارائه میکنند. ظرفیت حافظه نیز در هر 2 پلتفرم SP7 و SP8 میتواند به 8 ترابایت در هر سوکت برسد.
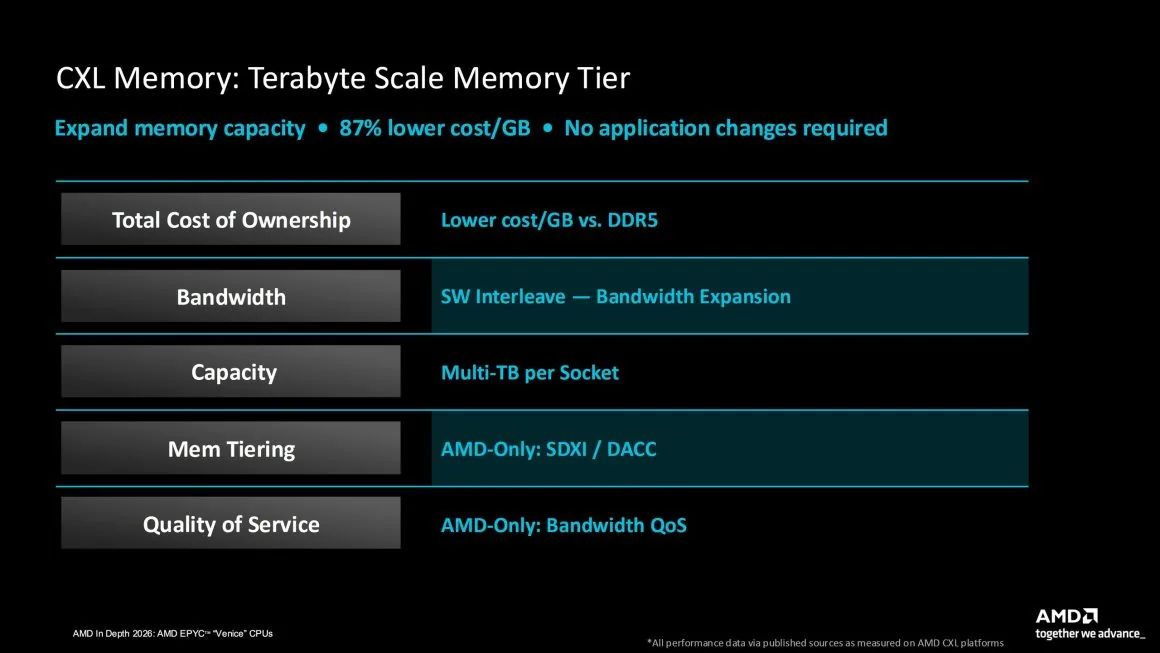
استاندارد CXL 3.1 با پشتیبانی از PCIe Gen6 در پلتفرم SP7 حداکثر 96 مسیر و در SP8 حداکثر 128 مسیر بهازای هر سوکت ارائه میدهد. هر مسیر x16 نیز در یک مرحله ارتباطی NUMA، حداکثر پهنای باند خام 128 گیگابایت بر ثانیه دارد. به گفته AMD فناوری CXL یک لایه حافظه در مقیاس ترابایت محسوب میشود که هزینه هر گیگابایت را تا 87 درصد کاهش میدهد. این فناوری همچنین بدون نیاز به ایجاد تغییر در برنامههای کاربردی سازگاری لازم را فراهم میکند.
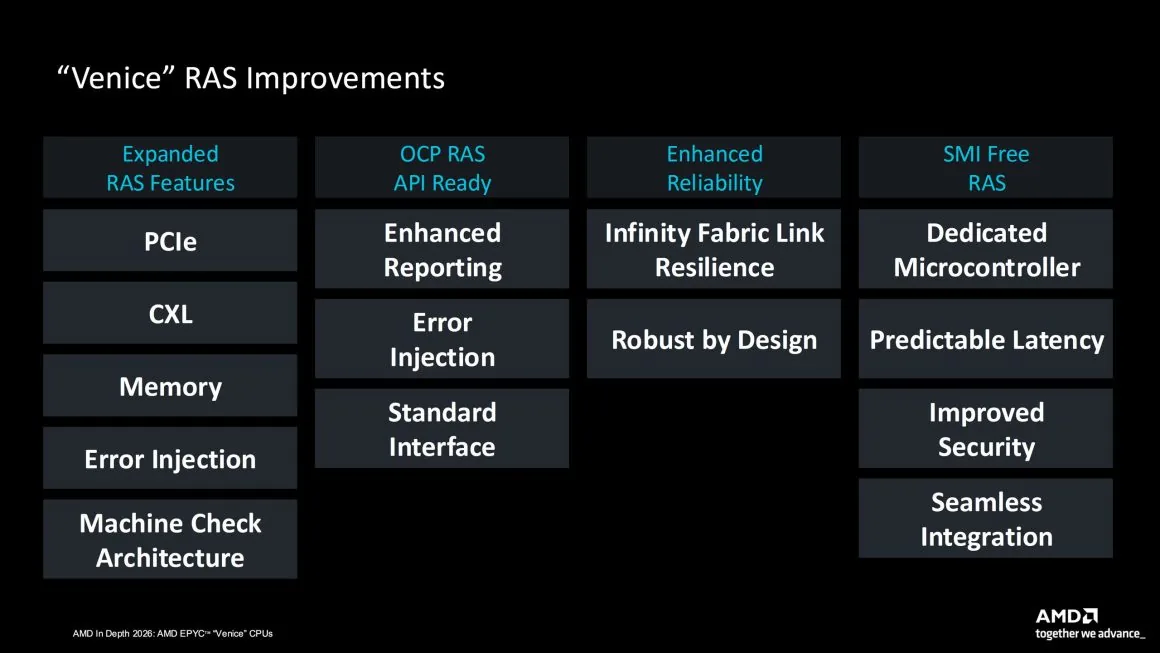
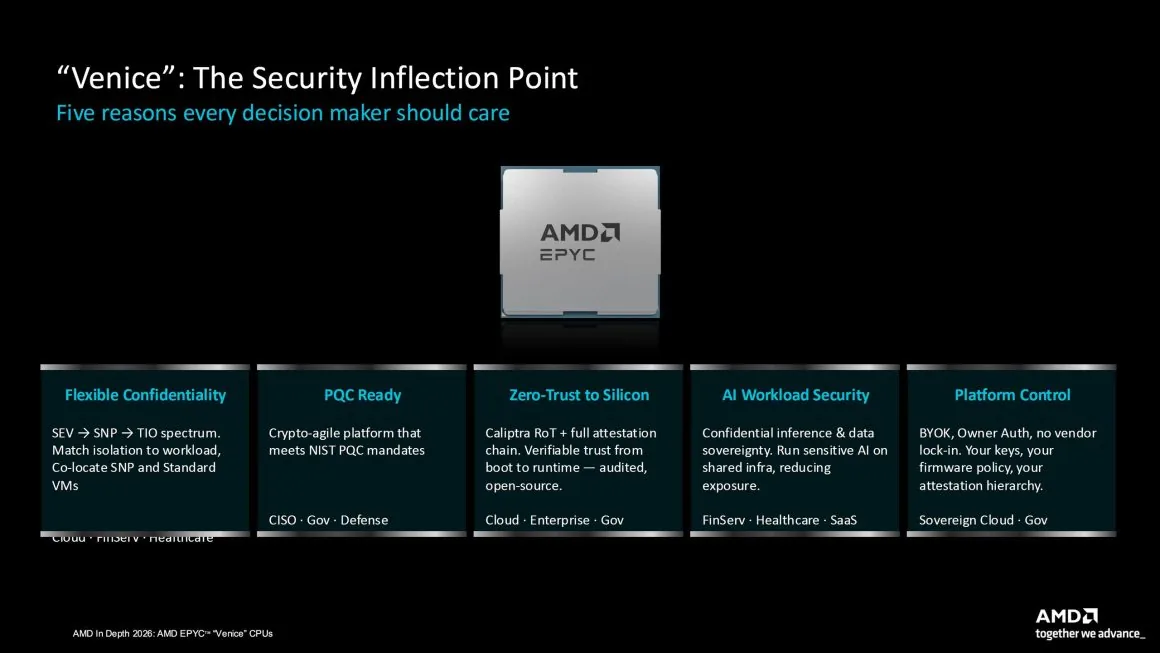
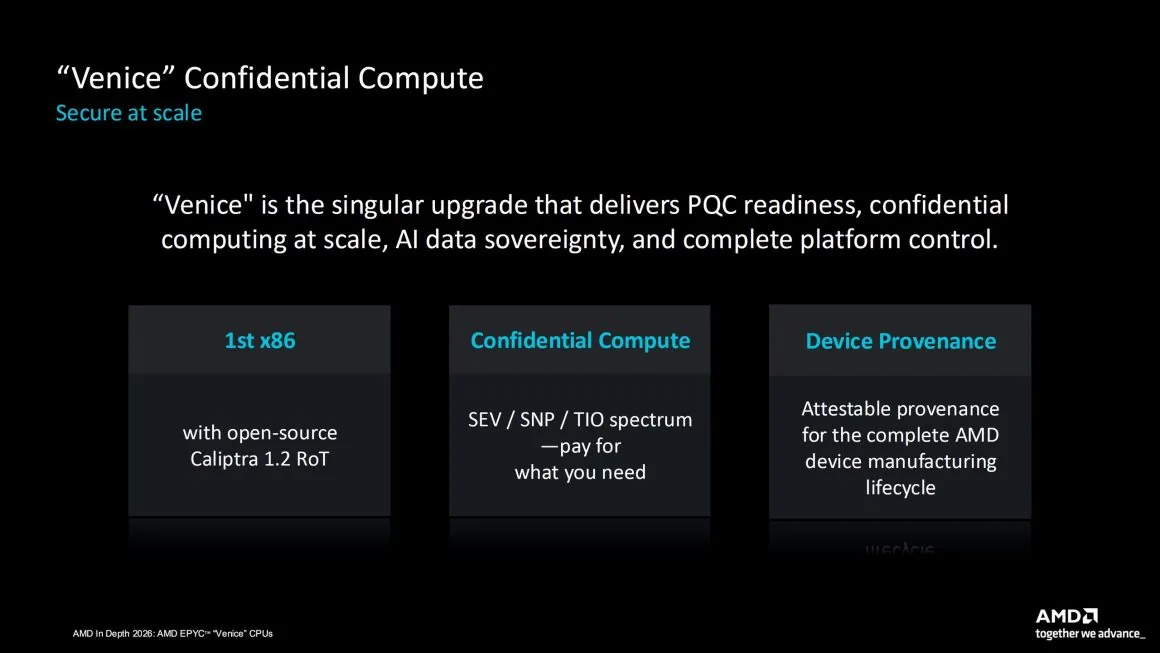
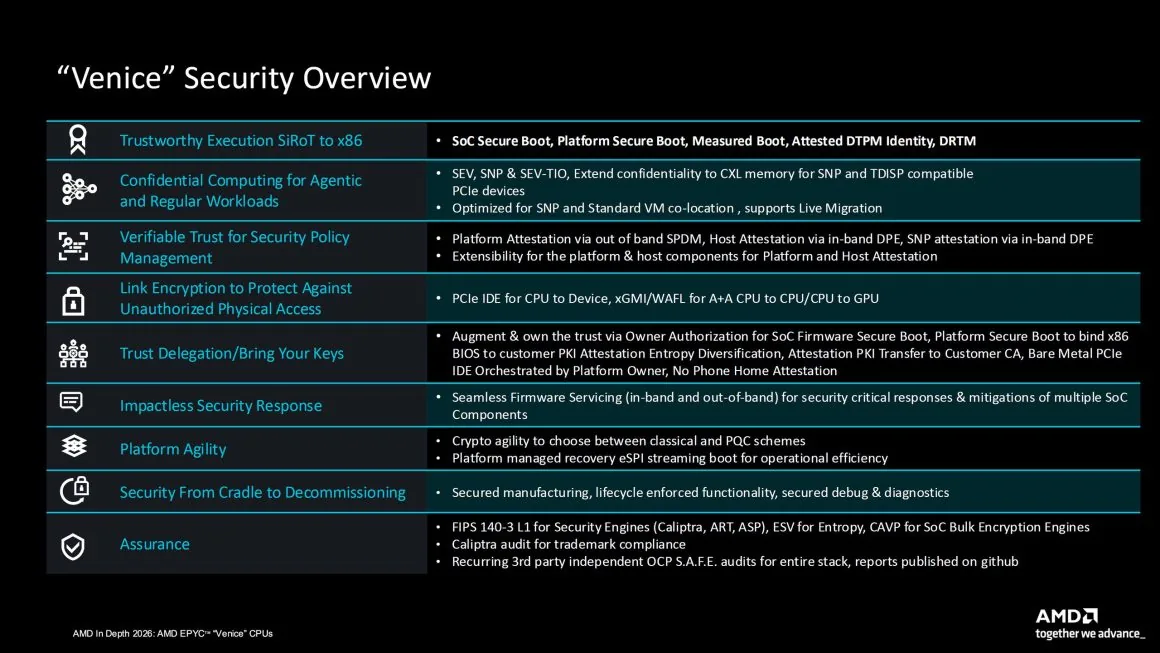
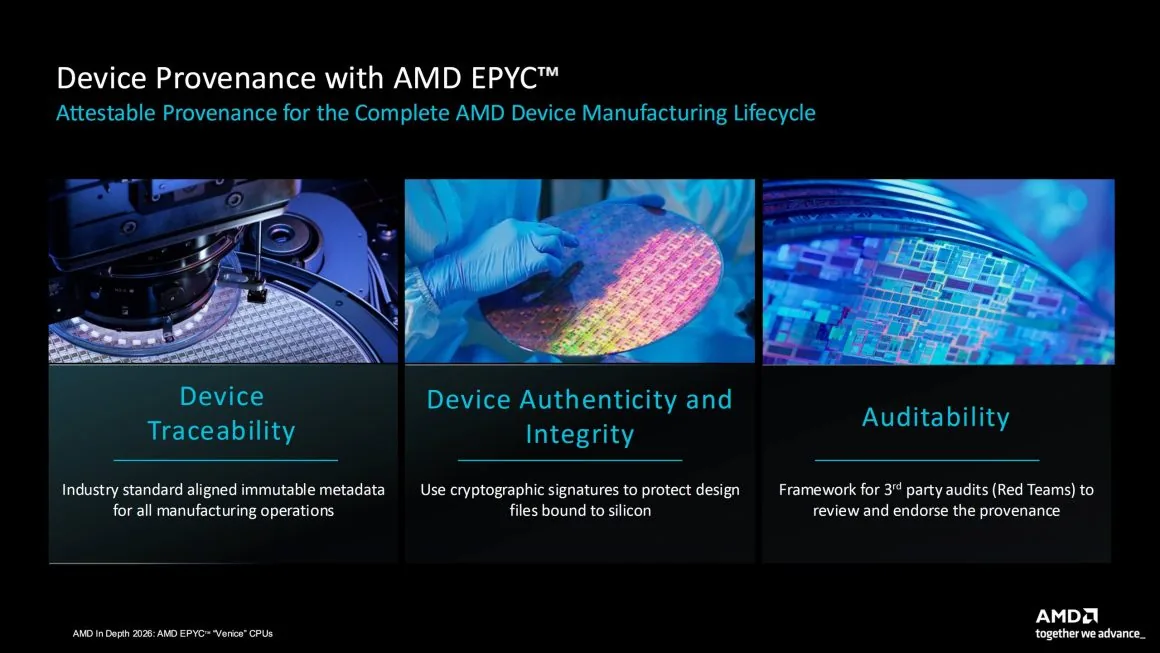
بهبود قابلیتهای امنیتی و اطمینانپذیری در Zen 6
هسته Zen 6 قابلیتهای RAS و امنیتی را نیز بهبود میدهد. این معماری نخستین معماری x86 محسوب میشود که از فناوری متنباز Caliptra 1.2 ROT بهره میبرد. علاوه بر این Zen 6 برای تامین نیازهای امنیتی پردازشهای هوش مصنوعی عاملمحور نیز آماده شده است.
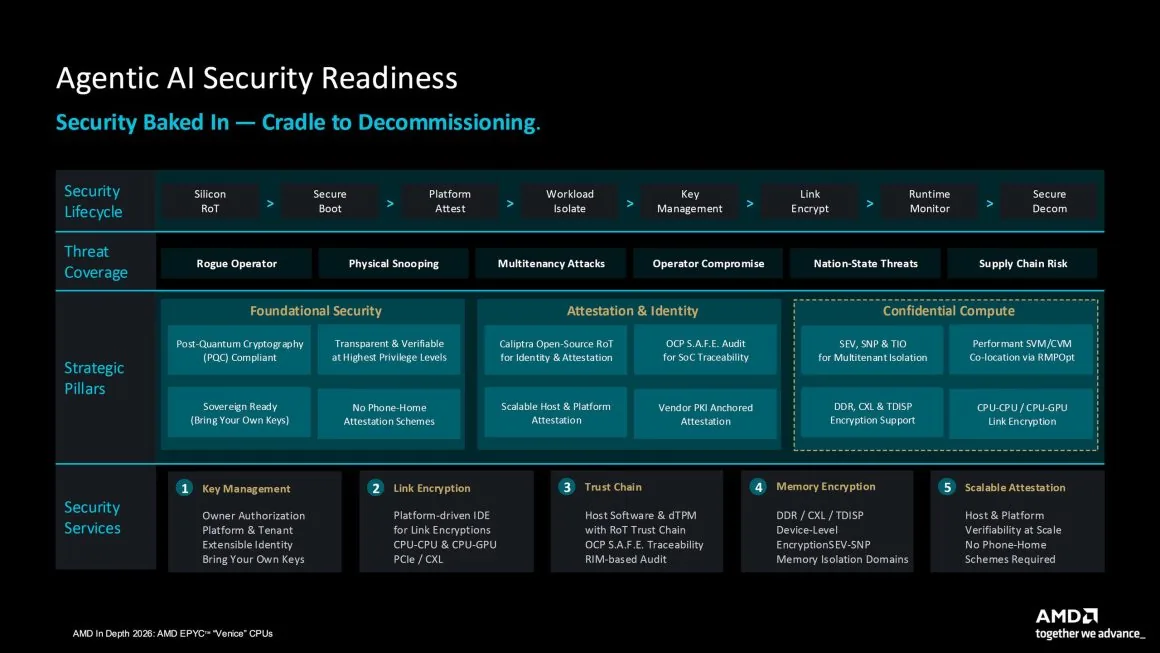
فناوریهای جدید AMD برای مدیریت مصرف انرژی در دیتاسنترها
AMD قصد دارد مشکل بهرهوری مصرف انرژی در دیتاسنترها را نیز برطرف کند. این شرکت 3 چالش اصلی را در این زمینه شناسایی کرده است. نخستین چالش با عنوان Stranded Power شناخته میشود. این مشکل به ظرفیت بلااستفاده رکها مربوط است؛ بهطوریکه حدود 15 تا 25 درصد از ظرفیت هر رک بدون استفاده باقی میماند.
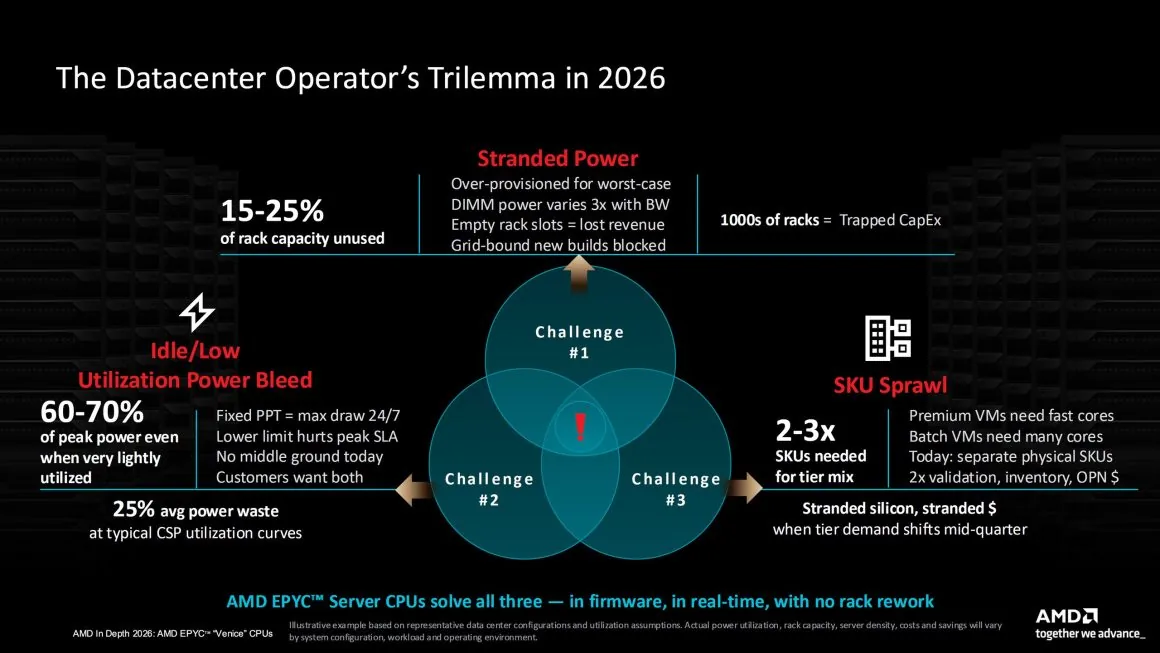
این میزان در مقیاس یک دیتاسنتر میتواند به هزاران رک برسد و در نهایت سرمایهگذاری انجامشده برای زیرساختها را بدون استفاده باقی بگذارد. دومین چالش هدررفت انرژی هنگام بیکاری یا استفاده محدود از منابع پردازشی است. طبق توضیحات AMD حتی زمانی که رکها با بار کاری کمی فعالیت میکنند، حدود 60 تا 70 درصد از حداکثر توان مصرفی آنها همچنان استفاده میشود. استفاده از محدودیت توان ثابت PPT باعث میشود رکها بهصورت شبانهروزی در محدوده حداکثر توان مصرفی خود باقی بمانند. از سوی دیگر کاهش بیش از حد این محدودیت نیز میتواند عملکرد را تحت تاثیر قرار دهد.
سومین چالش به تعدد SKUها مربوط میشود. برای پوشش سطوح مختلف خدمات گاهی به 2 تا 3 برابر SKU بیشتر نیاز است. ماشینهای مجازی پیشرفته (Premium VM) به هستههای سریعتر احتیاج دارند درحالیکه ماشینهای مجازی پردازش دستهای (Batch VM) به تعداد هستههای بیشتر نیازمند هستند.
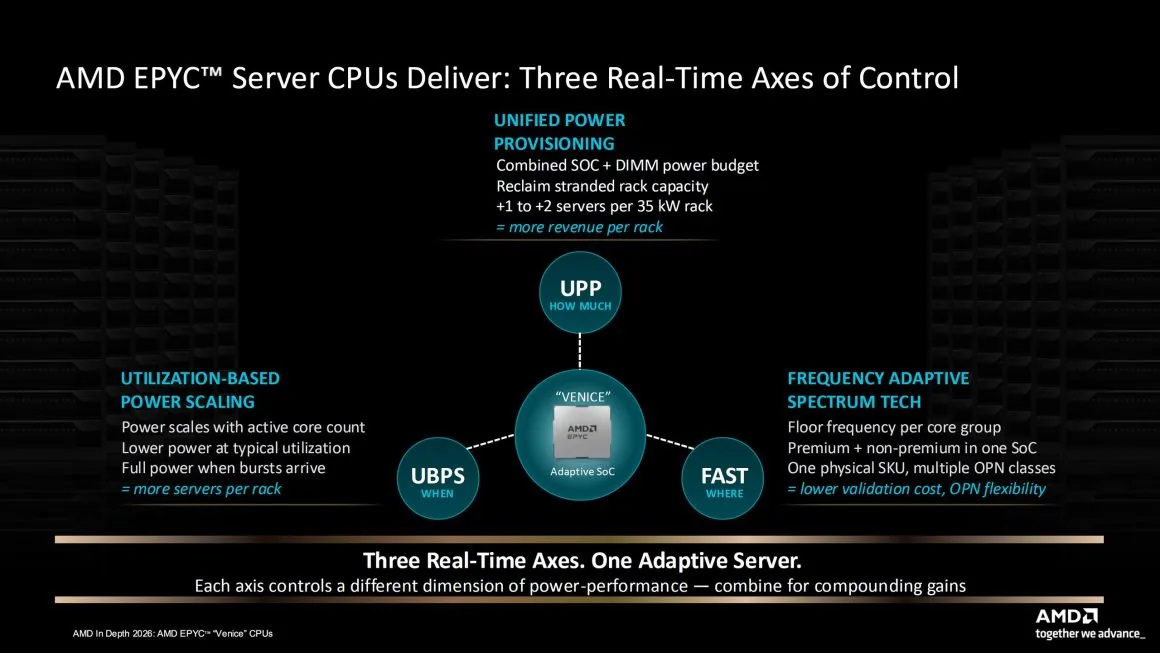
این موضوع باعث میشود بخشی از ظرفیت پردازشی و سرمایهگذاری انجامشده روی تراشهها بلااستفاده باقی بماند؛ بهخصوص زمانی که تقاضا برای سطوح مختلف خدمات در میانه یک فصل مالی تغییر میکند. AMD برای حل این 3 مشکل فناوریهای UPP، UBPS و FAST را معرفی کرده است.
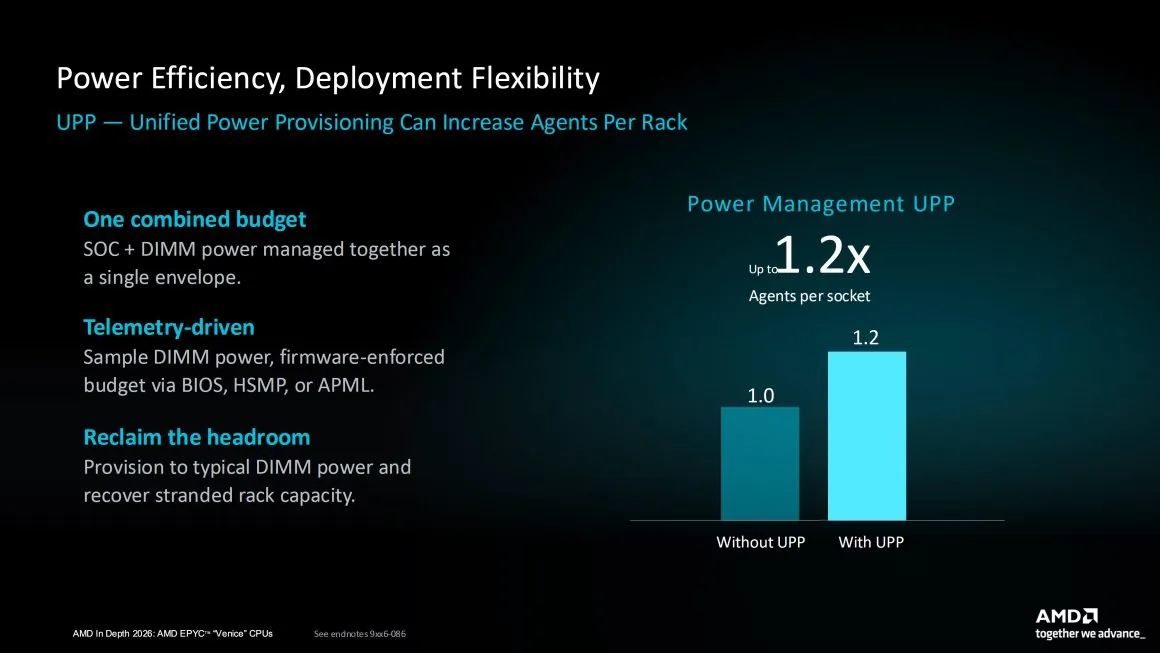
فناوری UPP یا Unified Power Provisioning: این فناوری ظرفیت بلااستفاده رکها را بازیابی میکند. در نتیجه امکان نصب سرورهای بیشتری در هر رک فراهم میشود و نسبت عملکرد پردازنده به هزینه کل مالکیت بهبود پیدا میکند.
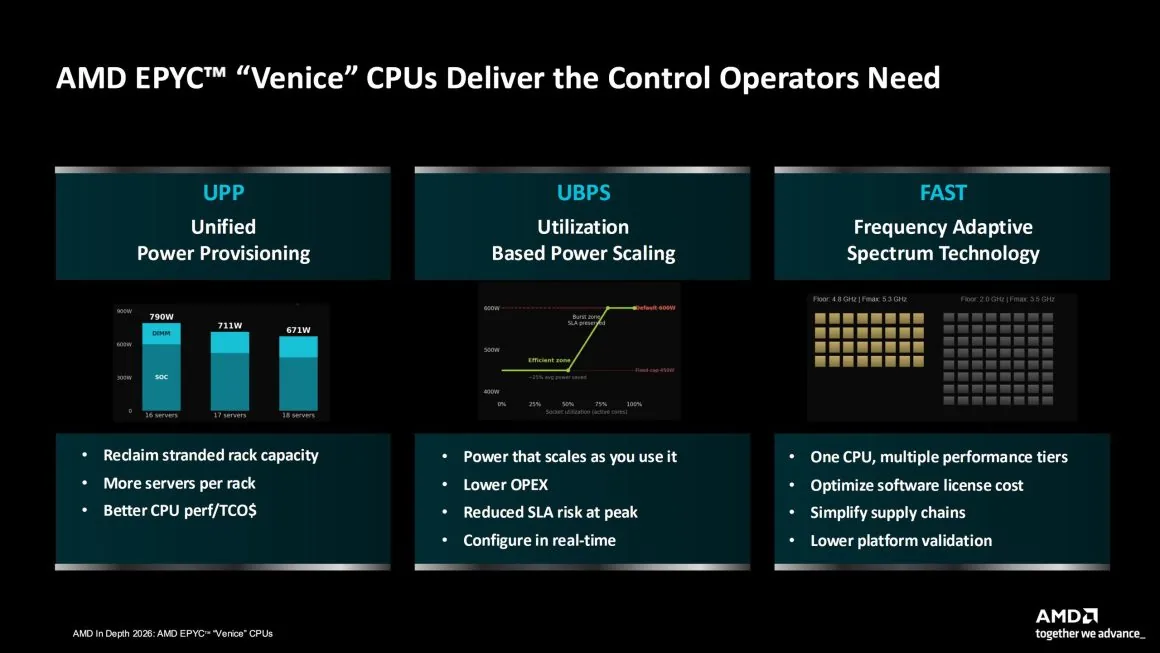
فناوری UBPS یا Utilization-Based Power Scaling: این فناوری امکان تنظیم مصرف انرژی را بر اساس تعداد هستههای فعال فراهم میکند. در شرایط استفاده معمول توان مصرفی کاهش مییابد اما هنگام افزایش ناگهانی بار پردازشی سیستم میتواند از حداکثر توان موجود استفاده کند.
فناوری FAST یا Frequency-Adaptive Spectrum Tech: این فناوری حداقل فرکانس مشخصی را برای گروههای مختلف هسته تعیین میکند. به این ترتیب امکان ترکیب هستههای پیشرفته و معمولی در یک SoC فراهم میشود. در عمل فناوری FAST میتواند یک پردازنده را به چند سطح عملکردی متفاوت تقسیم کند تا نیازهای مختلف پردازشی بدون استفاده از SKUهای متعدد برطرف شوند.
عملکرد پردازندههای EPYC Venice در مقایسه با نسلهای قبلی
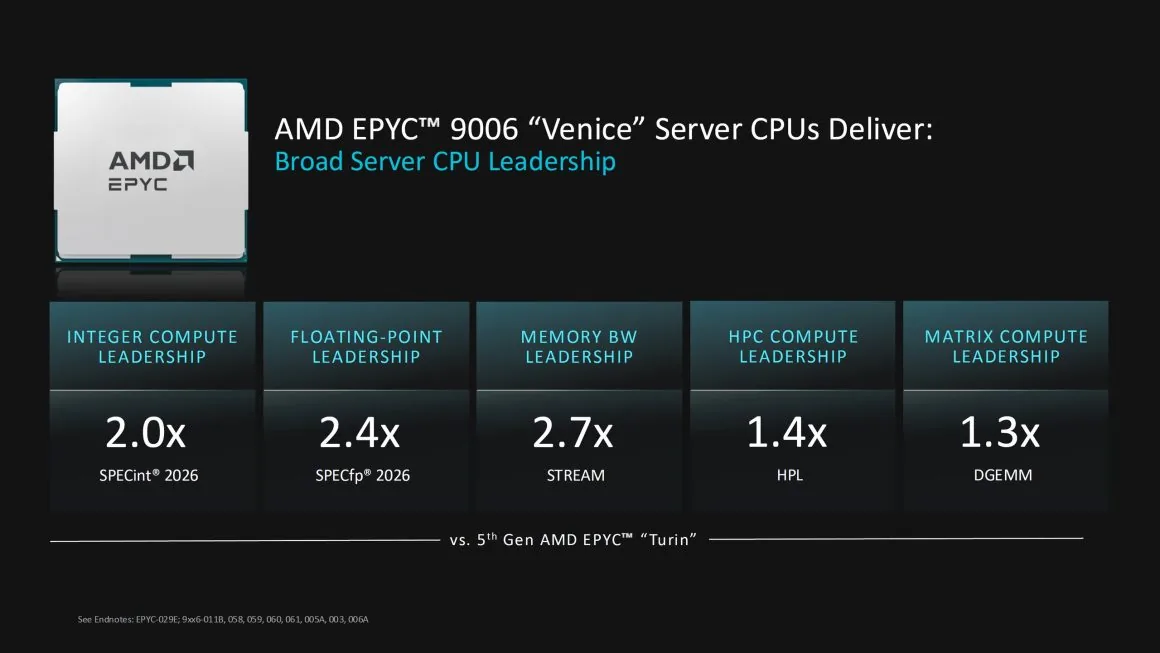
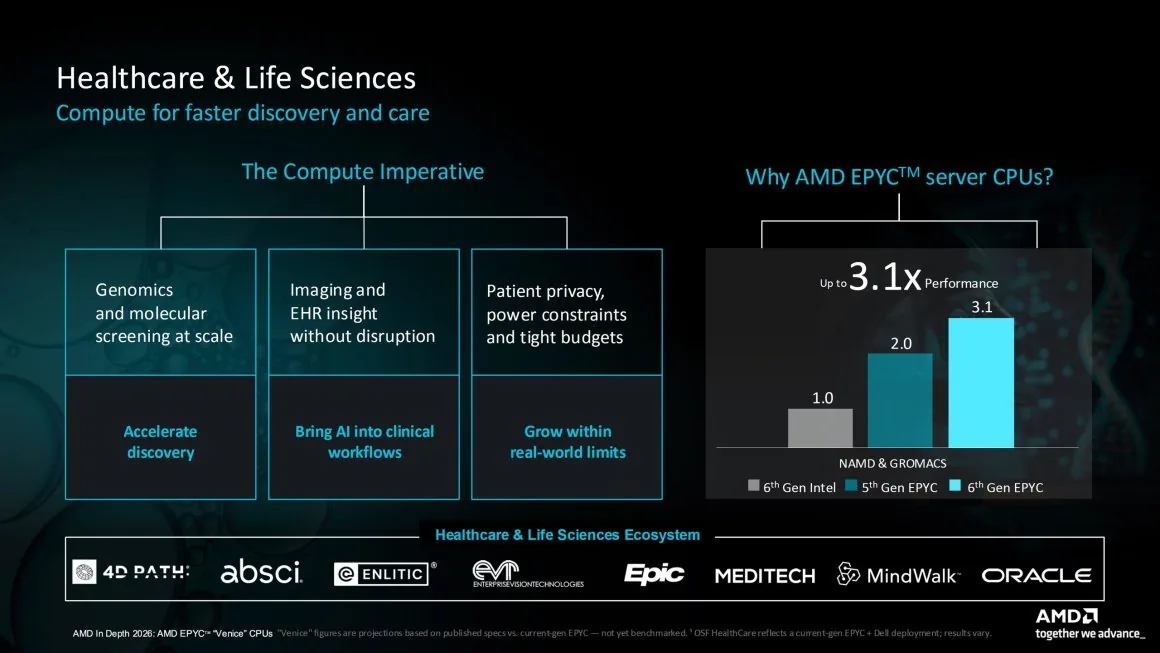
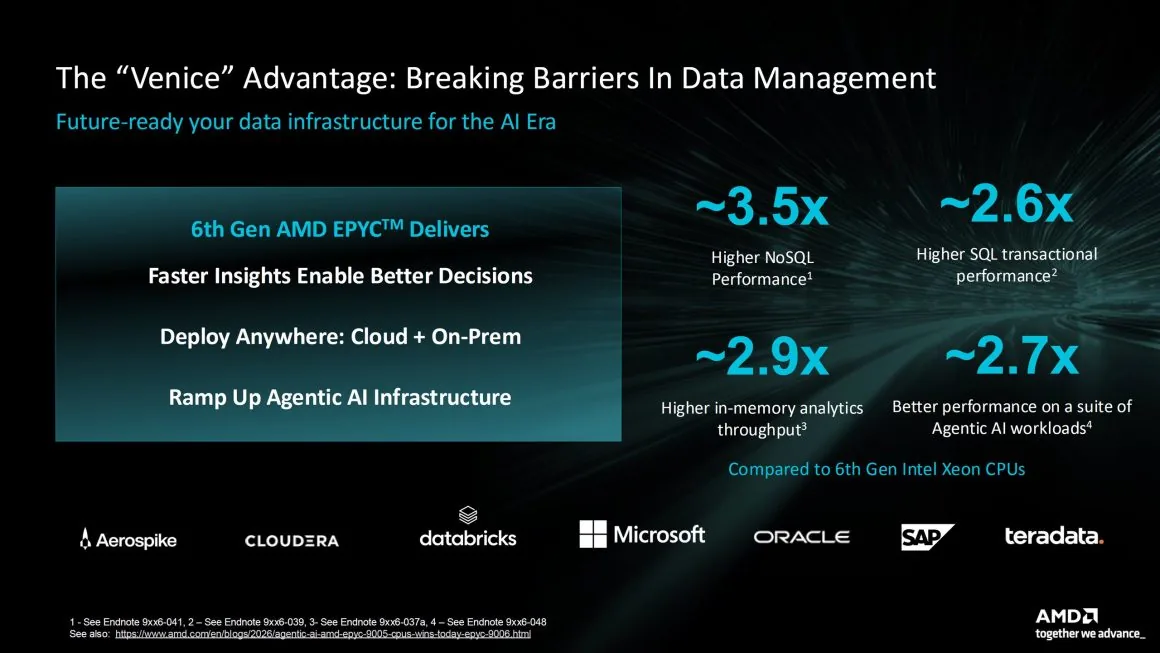
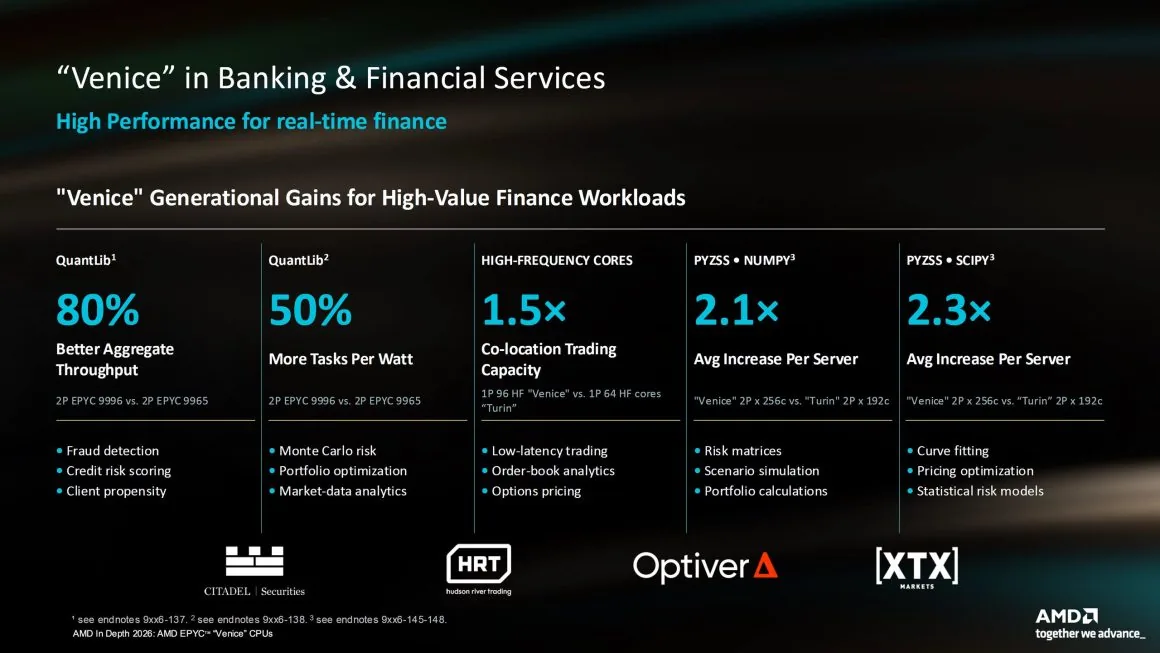
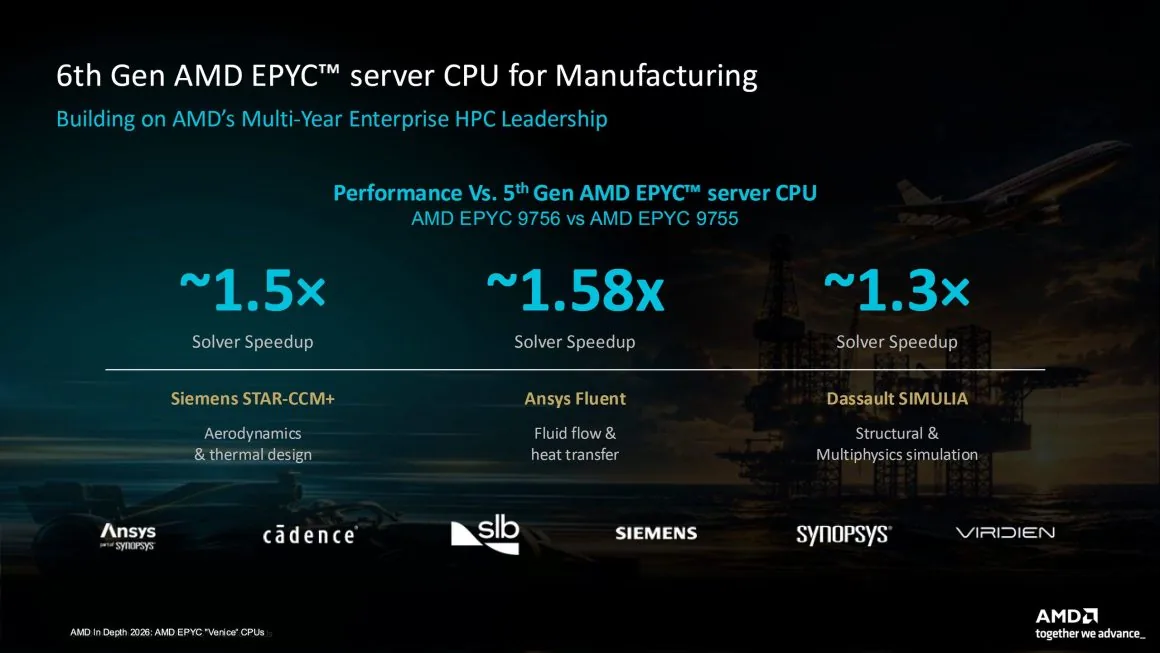
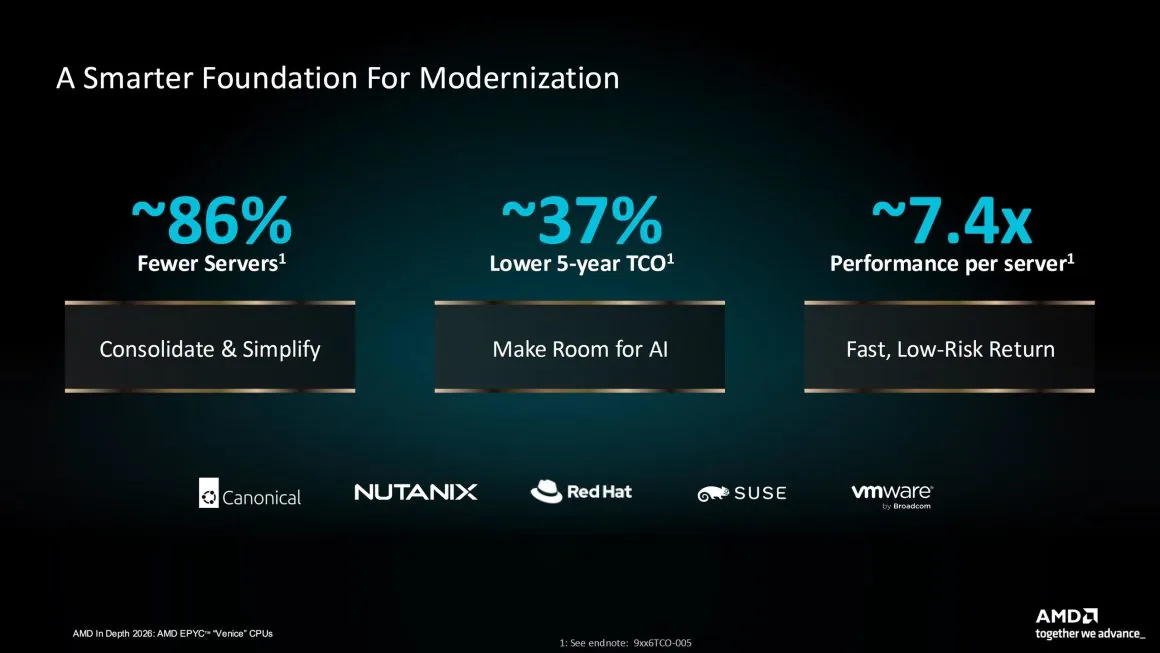
مجموع تغییرات معماری Zen 6 باعث شده است پردازندههای EPYC 9006 با اسم رمز Venice افزایش عملکرد چشمگیری نسبت به نسلهای قبلی ارائه کنند. AMD ادعا میکند پردازندههای EPYC 9006 در پردازشهای عمومی (General Purpose Compute) نسبت به نخستین نسل پردازندههای EPYC حدود 20 برابر عملکرد بهتری دارند.
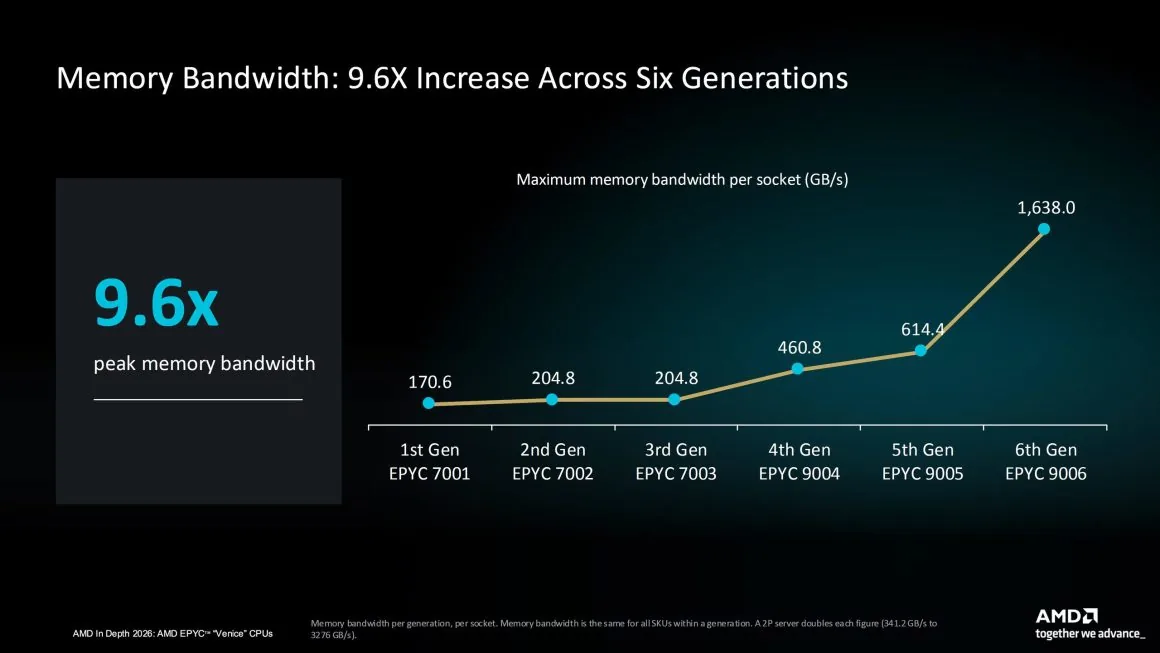
این پیشرفت در پردازشهای علمی به 18.6 برابر میرسد. پهنای باند حافظه نیز 9.6 برابر افزایش یافته است. AMD همچنین از عملکرد رقابتی این پردازندهها در مقایسه با محصولات شرکتهای رقیب خبر میدهد. در زمینه پهنای باند حافظه پردازنده EPYC Venice با استفاده از حافظه DDR5 MRDIMM به حداکثر 1.6 ترابایت بر ثانیه دست پیدا میکند. این رقم در پردازنده Vera شرکت انویدیا با حافظه LPDDR5X SOCAMM2 برابر با 1.2 ترابایت بر ثانیه است.
حتی با استفاده از حافظه RDIMM با سرعت 8000 MT/s نیز پردازنده Venice پهنای باند بیشتری نسبت به پردازنده Granite Rapids-AP اینتل با حافظه نسل اول MRDIMM و سرعت 8800 MT/s ارائه میکند. بر اساس اطلاعات منتشرشده پهنای باند این 2 پلتفرم بهترتیب 0.844 و 1 ترابایت بر ثانیه است. البته میدانیم که اینتل نیز قصد دارد سال آینده از حافظه MRDIMM نسل دوم پشتیبانی کند.
عملکرد پردازندههای Venice در پردازشهای HPC
در زمینه پردازشهای محاسباتی با عملکرد بالا (HPC)، معماری Venice افزایش عملکرد 11 برابری نسبت به نخستین نسل EPYC ارائه میکند. این میزان تقریباً 2 برابر پیشرفت پردازندههای Turin است. طبق نتایج کامل آزمایشهای عملکردی AMD پردازندههای Venice بهطور میانگین 2.2 برابر سریعتر از پردازندههای Granite Rapids اینتل عمل میکنند. برتری این پردازندهها در برخی آزمایشها به 3.2 برابر نیز میرسد.
حتی مدلهایی با 25 درصد هسته کمتر نیز میتوانند 1.6 برابر عملکرد بهتری نسبت به قدرتمندترین پردازنده 128 هستهای Granite Rapids Xeon ارائه کنند. در این مقایسه پردازنده 128 هستهای Xeon 6980P با مدل 96 هستهای EPYC 9686F مقایسه شده است.
در مقایسه مدلهایی با تعداد هسته تقریباً یکسان، پردازندههای EPYC Venice بهطور میانگین 1.9 برابر عملکرد بهتری ارائه میکنند. این برتری تقریباً 2 برابر بیشتر از اختلاف عملکرد پردازندههای Turin مبتنی بر Zen 5 با تعداد هسته یکسان است.
یکی دیگر از آزمایشهای جالب مدتزمان موردنیاز برای رسیدن پردازندههای EPYC Venice به نتیجه در شبیهسازیها است. به دلیل سرعت بالاتر شبیهسازیها در معماری Zen 6، پردازندههای Venice میتوانند پیشبینی وضعیت آبوهوا را در مقایسه با پردازندههای Turin با تعداد هسته یکسان، 2.8 برابر سریعتر انجام دهند.
برای مثال پردازنده 128 هستهای Turin یک شبیهسازی را در مدت 5.22 ساعت تکمیل میکند. این زمان در پردازنده 96 هستهای Venice به 3.49 ساعت کاهش مییابد. مدل 256 هستهای Venice نیز همین پردازش را تنها در 2.66 ساعت به پایان میرساند. نتایج مشابهی در پیشبینیهای 5 روزه آبوهوا نیز مشاهده شده است.
شبیهسازیهای مربوط به کشف دارو نیز در پردازندههای Venice با سرعت بیشتری انجام میشوند. برای مثال تکمیل یک شبیهسازی 100 نانوثانیهای در مقایسه با Granite Rapids حدود 4 ماه زودتر انجام میشود. پردازنده 256 هستهای Venice این شبیهسازی را در 57 روز به پایان میرساند. این زمان برای مدل 96 هستهای Venice به 97 روز میرسد. در مقابل پردازنده 128 هستهای Turin به 114 روز زمان نیاز دارد. پردازنده Granite Rapids اینتل نیز همین وظیفه را در 182 روز تکمیل میکند.
شبیهسازیهای مربوط به خودرو و آیرودینامیک نیز پیشرفت مشابهی را در پردازندههای Venice نشان میدهند. AMD همچنین اعلام کرده است که پردازندههای Venice در مقایسه با Vera شرکت انویدیا تعداد رشتههای پردازشی بیشتری بهازای هر مگاوات ارائه میکنند. این برتری در برخی شرایط به 2.9 برابر میرسد. عملکرد بهازای هر مگاوات نیز تا 2 برابر افزایش یافته است. علاوه بر این تعداد هستههای قابل استفاده در هر رک نیز بیشتر خواهد بود.
عملکرد پردازندههای Venice در پردازشهای هوش مصنوعی
در ادامه نوبت به آزمایشهای هوش مصنوعی میرسد. پردازندههای Venice از ابتدا با هدف اجرای پردازشهای پیشرفته هوش مصنوعی عاملمحور طراحی شدهاند. افزایش عملکرد این پردازندهها نیز قابلتوجه است. طبق ادعای AMD معماری Venice در مقایسه با EPYC Turin مبتنی بر Zen 5 تا 1.5 برابر عملکرد بهتری ارائه میکند. این برتری در مقایسه با پردازندههای Granite Rapids Xeon اینتل به 4.4 برابر میرسد.
AMD همچنین برتری خود در پردازشهای HPC و هوش مصنوعی را با پردازندههای Graviton5 شرکت آمازون مقایسه کرده است. این شرکت مدعی است پردازندههای Venice تا 3 برابر عملکرد بهتری ارائه میکنند. AMD در عین حال میگوید پردازندههای Turin فعلی نیز از هماکنون 60 درصد عملکرد بهتری نسبت به محصولات رقیب دارند.
با عرضه عمومی خانواده Venice شرکت AMD یک جهش معماری قابلتوجه برای دوران هوش مصنوعی عاملمحور ارائه کرده است. ترکیب افزایش حدود 27 درصدی IPC، تعداد بسیار بیشتر هستهها، حافظههای کش گستردهتر و پلتفرمهای جدید SP7 و SP8، در کنار مدیریت هوشمندتر مصرف انرژی، حافظههای نسل جدید و قابلیتهای پیشرفته ورودی و خروجی، پردازندههای EPYC 9006 را به گزینهای قدرتمند برای دیتاسنترهای ابری متراکم، پردازشهای محاسباتی سنگین و کاربردهای هوش مصنوعی تبدیل میکند. این تغییرات در نهایت مزایای قابلتوجهی از نظر عملکرد، بهرهوری انرژی و کاهش هزینه کل مالکیت برای مشتریان سازمانی به همراه خواهند داشت.