

شرکت OpenAI جزئیات تازهای از همکاری خود با AMD منتشر کرده است. در این همکاری، مهندسان با کمک مدلهای هوش مصنوعی معرفینشده، طراحی سختافزاری نسل آینده پردازندههای گرافیکی و مرکزی AMD را بهینهسازی کردهاند. مهمترین دستاورد این پروژه، بهبود حداکثر ۱۴ درصدی شاخص توان مصرفی، عملکرد و مساحت (PPA) در مدارهای پردازنده گرافیکی بوده است.
شرکت OpenAI جزئیات تازهای از همکاری خود با AMD منتشر کرده است.
در این همکاری، مهندسان با کمک مدلهای هوش مصنوعی معرفینشده، طراحی سختافزاری نسل آینده پردازندههای گرافیکی و مرکزی AMD را بهینهسازی کردهاند. مهمترین دستاورد این پروژه، بهبود حداکثر ۱۴ درصدی شاخص توان مصرفی، عملکرد و مساحت (PPA) در مدارهای پردازنده گرافیکی بوده است. همچنین بهبودهایی در حد چند درصد برای پردازنده مرکزی به دست آمده، هرچند میزان دقیق آن اعلام نشده است.
OpenAI اعلام کرده مدل هوش مصنوعی این شرکت با بازنویسی کدهای توصیفکننده مدارهای تراشه، توانسته فرصتهای تازهای برای بهینهسازی پیدا کند. این فرایند با استفاده از زبان SystemVerilog RTL انجام شده که یکی از زبانهای رایج در طراحی تراشههای پیشرفته به شمار میرود.
این شرکت مدعی است تلاشهای مدل هوش مصنوعی برای بهینهسازی طراحی، معادل فشردهسازی یک سال فعالیت معمول مهندسان طراحی تراشه در کمتر از پنج ماه بوده است؛ دستاوردی که از نظر OpenAI در این حوزه کمسابقه محسوب میشود.
OpenAI همچنین میگوید مدل این شرکت توانسته کدهای RTL را در سطح یک متخصص معماری ریزپردازنده تحلیل و بهینهسازی کند. این شرکت انتظار دارد در مراحل بعدی، بهبودهای بیشتری در شاخص PPA پردازندههای گرافیکی و مرکزی AMD به دست آورد و عملکرد آنها را فراتر از نتایج فعلی ارتقا دهد.
سابقه همکاری OpenAI در طراحی تراشه با هوش مصنوعی
این نخستین تجربه هوش مصنوعی در زمینه طراحی تراشه نیست. OpenAI پیشتر با همکاری برودکام روی توسعه تراشه OpenAI Jalapeño کار کرده بود؛ پردازندهای اختصاصی که برای اجرای وظایف استنتاج هوش مصنوعی طراحی شده است. نمونههای مهندسی این تراشه از ژوئن ۲۰۲۶ توانایی اجرای بارهای کاری واقعی را داشتند.
این شرکت انتظار داشت نخستین عرضه محدود Jalapeño در اواخر سال ۲۰۲۶ انجام شود و عرضه گستردهتر آن به سال ۲۰۲۷ موکول شود. نتایج آزمایشهای عملکردی این تراشه نیز مدتی است منتشر شدهاند و طبق ادعاهای مطرحشده، در وظایف پیشبینی تکتوکنی، مصرف انرژی و تأخیر پردازشی کمتری نسبت به پردازندههای گرافیکی پیشرفته Nvidia Blackwell ارائه میدهد.
آزمایش توانایی مدلهای GPT در طراحی تراشه
بخش دیگری از گزارش OpenAI به روند پیشرفت توانایی مدلهای GPT در طراحی تراشه اختصاص دارد. پژوهشگران برای ارزیابی مدلهای زبانی بزرگ پیشرفته، از آنها خواستند هستههای پردازشی PicoRV32 و Ibex را بهینهسازی کنند.
در هر مرحله از آزمایش، ۱۱۲ هزار توکن در اختیار مدلها قرار گرفت و از آنها خواسته شد توان عملیاتی تراشه را بهبود دهند. این شاخص ترکیبی از تعداد دستورالعملهای اجراشده در هر چرخه ساعت (IPC) و مدتزمان هر چرخه پردازشی محسوب میشود. سپس عملکرد طراحیهای ارائهشده توسط مدلها امتیازدهی شد.
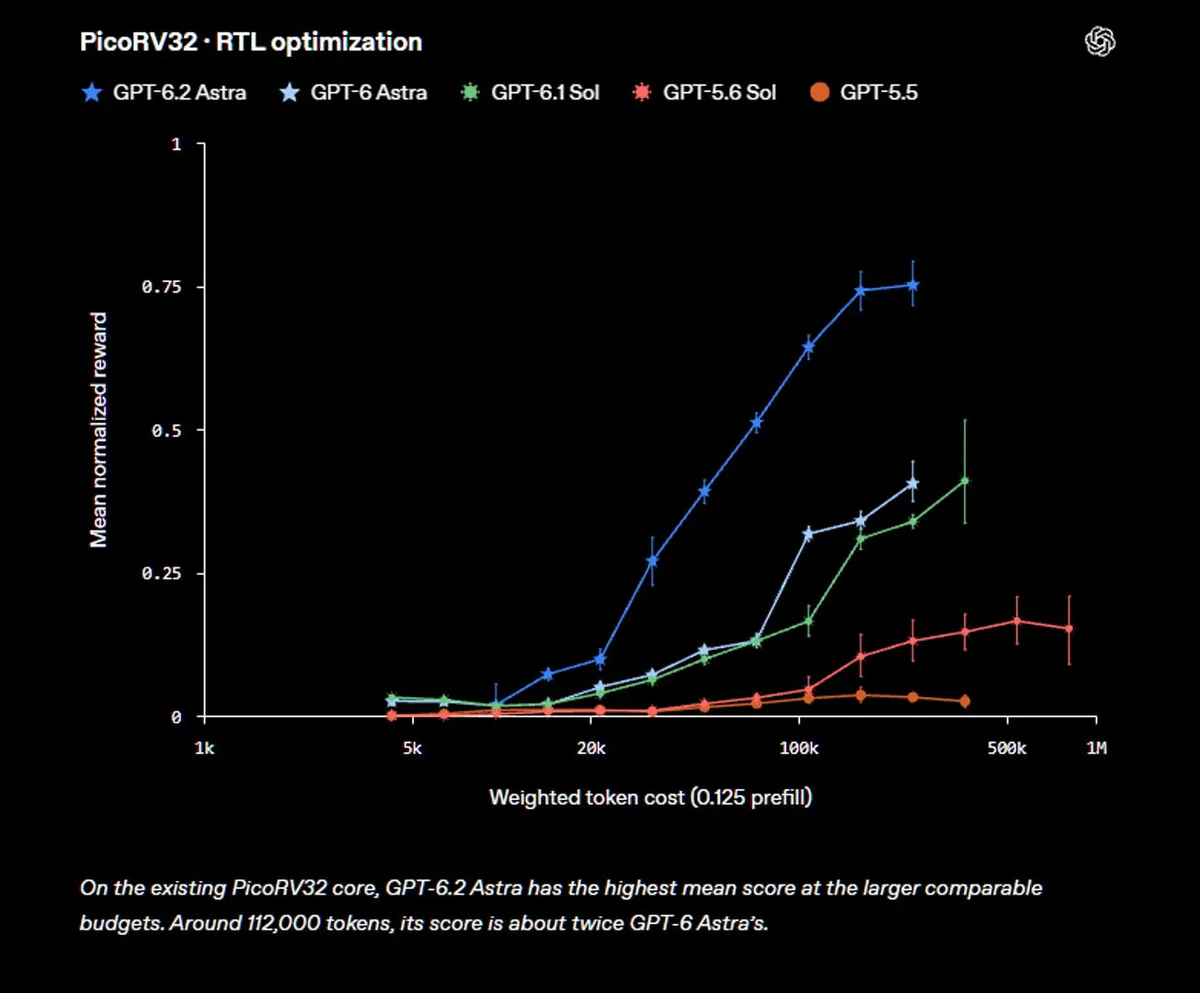
در این ارزیابی، اگر تراشه طراحیشده کار نمیکرد یا مساحت آن بیش از ۱۶ برابر مقدار اولیه میشد، امتیاز صفر دریافت میکرد. در مقابل، بهترین طراحیهایی که محدودیتهای آزمایش را رعایت میکردند، امتیاز ۱ دریافت میکردند.
نکته دیگر اینکه پژوهشگران نوع بارهای کاری مورد استفاده تراشهها را به مدلهای هوش مصنوعی اعلام نکردند. مطابق انتظار، GPT-6.2 Astra عملکرد بسیار بهتری نسبت به سایر مدلها نشان داد و در هر دو معیار، یعنی کمترین هزینه کلی و بالاترین امتیاز بهینهسازی، در جایگاه نخست قرار گرفت.
آزمایش دوم نیز نتیجه جالبی به همراه داشت. مدلهای هوش مصنوعی زمانی نتایج بهتری ارائه کردند که بهجای بهینهسازی کدهای موجود، تراشهها را بر اساس مشخصات اولیه آنها از ابتدا بازطراحی کردند.
هنوز مشخص نیست پژوهشگران برای انجام این پروژه از نسخههای استاندارد و بدون تغییر GPT استفاده کردهاند یا سراغ مدلهای اختصاصی رفتهاند. در حال حاضر، مدلهای زبانی بزرگ پیشرفته و تخصصی برای چنین وظایفی وجود دارند که استفاده از آنها هزینه بالایی به همراه دارد.
OpenAI نیز تأیید کرده که با همکاری سیناپسیس روی توسعه GPT-Synopsys کار میکند؛ مدلی تخصصی که برای استفاده از ابزارهای طراحی تراشه و خودکارسازی فرایندهای مرتبط با این حوزه آموزش میبیند.